Znajdowanie i naprawianie wąskich gardeł wydajności O(n²): Lekcje z optymalizacji algorytmów Cal.com
Dogłębne spojrzenie na to, jak wykrywaliśmy, analizowaliśmy i optymalizowaliśmy słabo działające algorytmy w rzeczywistej produkcyjnej bazie kodu.

On this page
- Wprowadzenie
- Problem: jak niewinny kod staje się O(n²)
- Studium przypadku 1: optymalizacja sprawdzania konfliktów slotów
- Pierwotny problem
- Pierwotna implementacja: zagnieżdżone pętle O(n²)
- Zoptymalizowana implementacja: O(n log n) dzięki sortowaniu i wcześniejszemu zakończeniu
- Studium przypadku 2: przecięcie zakresów dat z użyciem techniki dwóch wskaźników
- Pierwotny problem
- Pierwotna implementacja: zagnieżdżone mapowanie O(n²)
- Zoptymalizowana implementacja: O(n log n) z przejściem dwoma wskaźnikami
- Studium przypadku 3: drzewo przedziałowe do filtrowania zbędnych zakresów
- Pierwotny problem
- Pierwotna implementacja: sprawdzanie zawierania O(n²)
- Zoptymalizowana implementacja: O(n log n) z drzewem przedziałowym
- Wyniki wydajności: przed i po
- Łatwe techniki wykrywania algorytmów O(n²)
- Rozpoznawaj wzorce problemów
- Testuj skalowalność wprost
- Automatyzuj analizę statyczną
- Sprawdzone strategie zastępowania kodu O(n²)
- Automatyzacja kontroli wydajności
- Najważniejsze wnioski
- Zakończenie
Wprowadzenie
Wąskie gardła wydajności w systemach planowania mogą przesądzić o różnicy między responsywnym doświadczeniem użytkownika a sytuacją, w której użytkownicy opuszczają Twoją platformę z frustracją. W Cal.com niedawno wykryliśmy i zoptymalizowaliśmy kilka krytycznych algorytmów O(n²), które powodowały spowolnienia wraz ze wzrostem liczby użytkowników i ilości danych.
W tym artykule podzielę się czterema rzeczywistymi optymalizacjami algorytmów z bazy kodu Cal.com. Dowiesz się, jak wykrywaliśmy złożoność O(n²), które strategie optymalizacji działały najlepiej i jak wdrożyliśmy automatyczne kontrole, aby zapobiec przyszłym regresjom.
Problem: jak niewinny kod staje się O(n²)
Wraz ze wzrostem platform do planowania zaskakująco łatwo jest, by pozornie niewinne zagnieżdżone pętle stały się cichymi zabójcami wydajności. Oto rzeczywisty przykład z naszej bazy kodu:
// O(n²): Every available slot is checked against every busy period
availableTimeSlots.map(slot => {
  return busy.some(busyTime => checkOverlap(slot, busyTime));
});
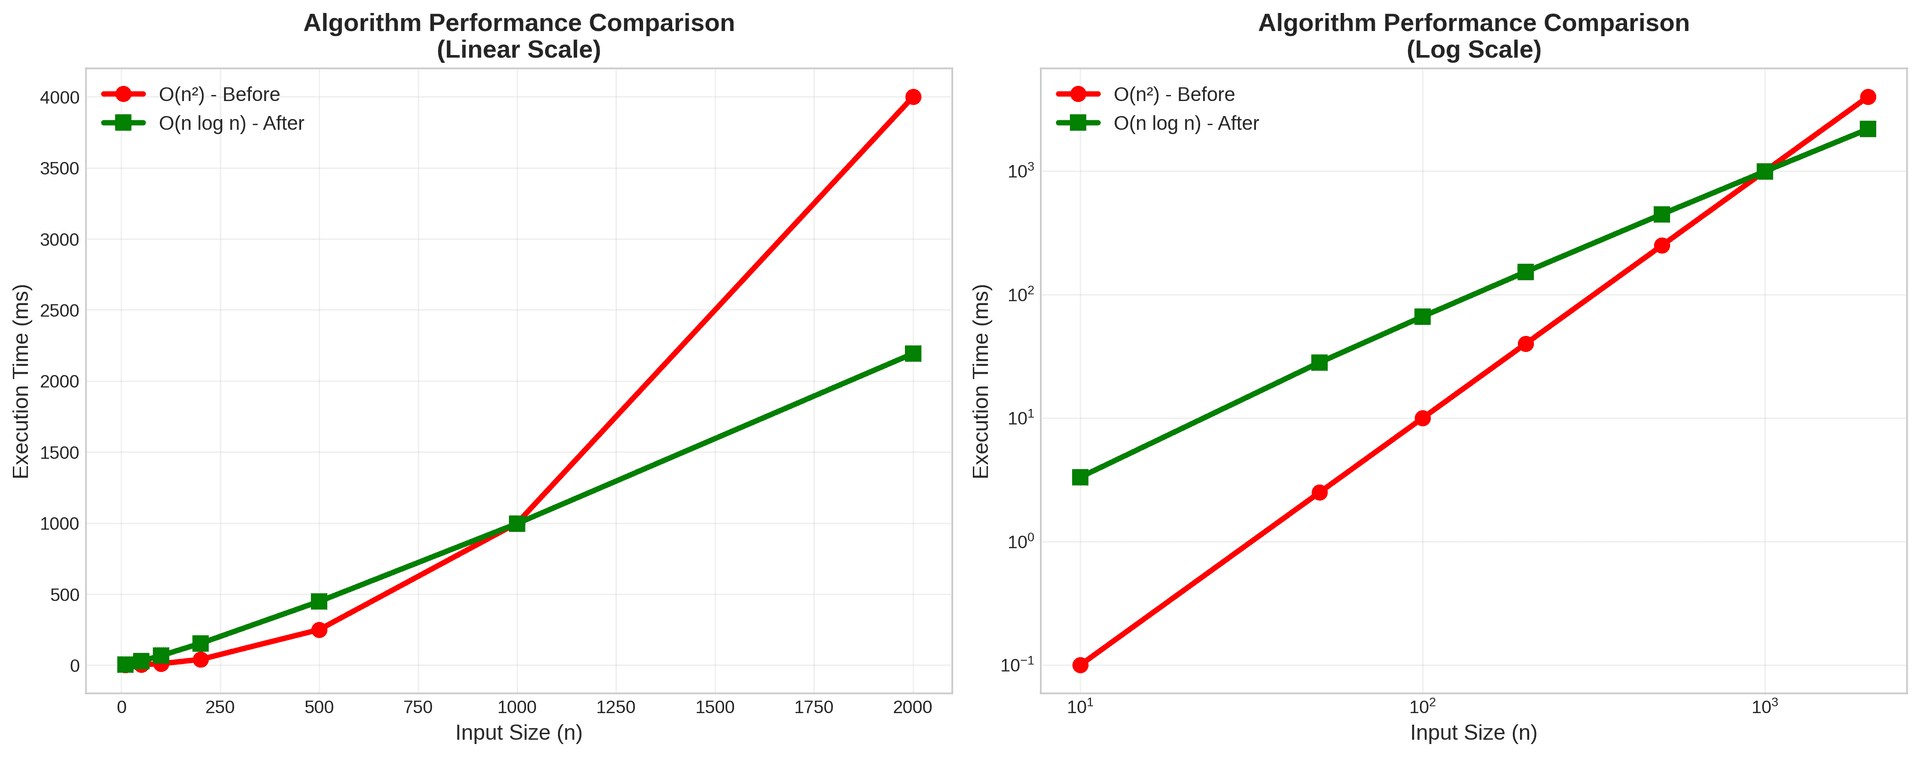
Dla 100 slotów i 50 okresów zajętości daje to 5000 sprawdzeń nakładania się. Na większą skalę — 500 slotów i 200 okresów zajętości — rośnie to do 100 000 operacji. To dwudziestokrotny wzrost obciążenia obliczeniowego przy tylko pięciokrotnym wzroście danych.
Studium przypadku 1: optymalizacja sprawdzania konfliktów slotów
Pierwotny problem
Funkcja checkForConflicts używała zagnieżdżonej iteracji, aby sprawdzić, czy sloty bookingów kolidują z okresami zajętości. Przy dużych harmonogramach bardzo szybko stało się to problemem z wydajnością.
Pierwotna implementacja: zagnieżdżone pętle O(n²)
function checkForConflicts({ busy, time, eventLength }) {
  return busy.some(busyTime => {
    const slotStart = time.valueOf();
    const slotEnd = slotStart + eventLength * 60 * 1000;
    const busyStart = dayjs.utc(busyTime.start).valueOf();
    const busyEnd = dayjs.utc(busyTime.end).valueOf();
    return !(busyEnd <= slotStart || busyStart >= slotEnd);
  });
}

availableTimeSlots = availableTimeSlots
  .map((slot) => {
    if (
      !checkForConflicts({
        time: slot.time,
        busy: busySlotsFromReservedSlots,
        ...availabilityCheckProps,
      })
    ) {
      return slot;
    }
    return undefined;
  })
Zoptymalizowana implementacja: O(n log n) dzięki sortowaniu i wcześniejszemu zakończeniu
function checkForConflicts({ sortedBusyTimes, time, eventLength }) {
  const slotStart = time.valueOf();
  const slotEnd = slotStart + eventLength * 60 * 1000;

  for (const busyTime of sortedBusyTimes) {
    if (busyTime.start >= slotEnd) {
      break;
    }
    if (busyTime.end <= slotStart) {
      continue;
    }
    return true;
  }
  return false;
}
Co się zmieniło:
Posortowaliśmy czasy zajętości według czasu rozpoczęcia, co pozwoliło nam pominąć okresy bez nakładania się i zakończyć działanie wcześniej, gdy konflikt nie był możliwy. Efektem był ogromny spadek liczby zbędnych porównań.
Wpływ:
Złożoność spadła z O(liczba dostępnych slotów × okresy zajętości) do O(n log n), a w typowych przypadkach większość sprawdzeń była całkowicie pomijana.
Studium przypadku 2: przecięcie zakresów dat z użyciem techniki dwóch wskaźników
Pierwotny problem
Funkcja intersect wcześniej używała zagnieżdżonych pętli, aby znajdować nakładania się dostępności wielu użytkowników.
Pierwotna implementacja: zagnieżdżone mapowanie O(n²)
commonAvailability.forEach(commonRange => {
  userRanges.forEach(userRange => {
    const intersection = getIntersection(commonRange, userRange);
    if (intersection !== null) {
      intersectedRanges.push(intersection);
    }
  });
});
Zoptymalizowana implementacja: O(n log n) z przejściem dwoma wskaźnikami
const sortedRanges = ranges.map(userRanges =>
  userRanges
    .map(r => ({
      ...r,
      startValue: r.start.valueOf(),
      endValue: r.end.valueOf()
    }))
    .sort((a, b) => a.startValue - b.startValue)
);

let commonIndex = 0;
let userIndex = 0;

while (commonIndex < commonAvailability.length && userIndex < userRanges.length) {
  const commonRange = commonAvailability[commonIndex];
  const userRange = userRanges[userIndex];

  const intersectStartValue = Math.max(commonRange.startValue, userRange.startValue);
  const intersectEndValue = Math.min(commonRange.endValue, userRange.endValue);

  if (intersectStartValue < intersectEndValue) {
    intersectedRanges.push(createIntersection(commonRange, userRange));
  }

  if (commonRange.endValue <= userRange.endValue) {
    commonIndex++;
  } else {
    userIndex++;
  }
}
Co się zmieniło:
Dzięki sortowaniu i użyciu dwóch wskaźników do przechodzenia przez zakresy wyeliminowaliśmy potrzebę zagnieżdżonej iteracji. To zmniejszyło złożoność z kwadratowej do niemal liniowej dla większości praktycznych danych wejściowych.
Studium przypadku 3: drzewo przedziałowe do filtrowania zbędnych zakresów
Pierwotny problem
Funkcja filterRedundantDateRanges sprawdzała każdy zakres względem każdego innego, aby ustalić, czy jeden zawiera drugi. Przy dużych harmonogramach działało to boleśnie wolno.
Pierwotna implementacja: sprawdzanie zawierania O(n²)
return dateRanges.filter((range, index) => {
  return !dateRanges.some((otherRange, otherIndex) => {
    if (index === otherIndex) return false;
    return isCompletelyContained(range, otherRange);
  });
});
Zoptymalizowana implementacja: O(n log n) z drzewem przedziałowym
export function filterRedundantDateRanges(dateRanges) {
  const sortedRanges = [...dateRanges].sort((a, b) => a.start.valueOf() - b.start.valueOf());
  const intervalNodes = createIntervalNodes(
    sortedRanges,
    (range) => range.start.valueOf(),
    (range) => range.end.valueOf()
  );
  const intervalTree = new IntervalTree(intervalNodes);
  const searchAlgorithm = new ContainmentSearchAlgorithm(intervalTree);

  return sortedRanges.filter((range, index) => {
    const containingIntervals = searchAlgorithm.findContainingIntervals(
      range.start.valueOf(),
      range.end.valueOf(),
      index
    );
    return containingIntervals.length === 0;
  });
}
Co się zmieniło:
Zamiast porównań brute force użyliśmy struktury drzewa przedziałowego, która umożliwia szybkie zapytania o zawieranie O(log n). To klasyczne podejście w geometrii obliczeniowej, które znakomicie sprawdza się w aplikacjach do planowania.
Wyniki wydajności: przed i po
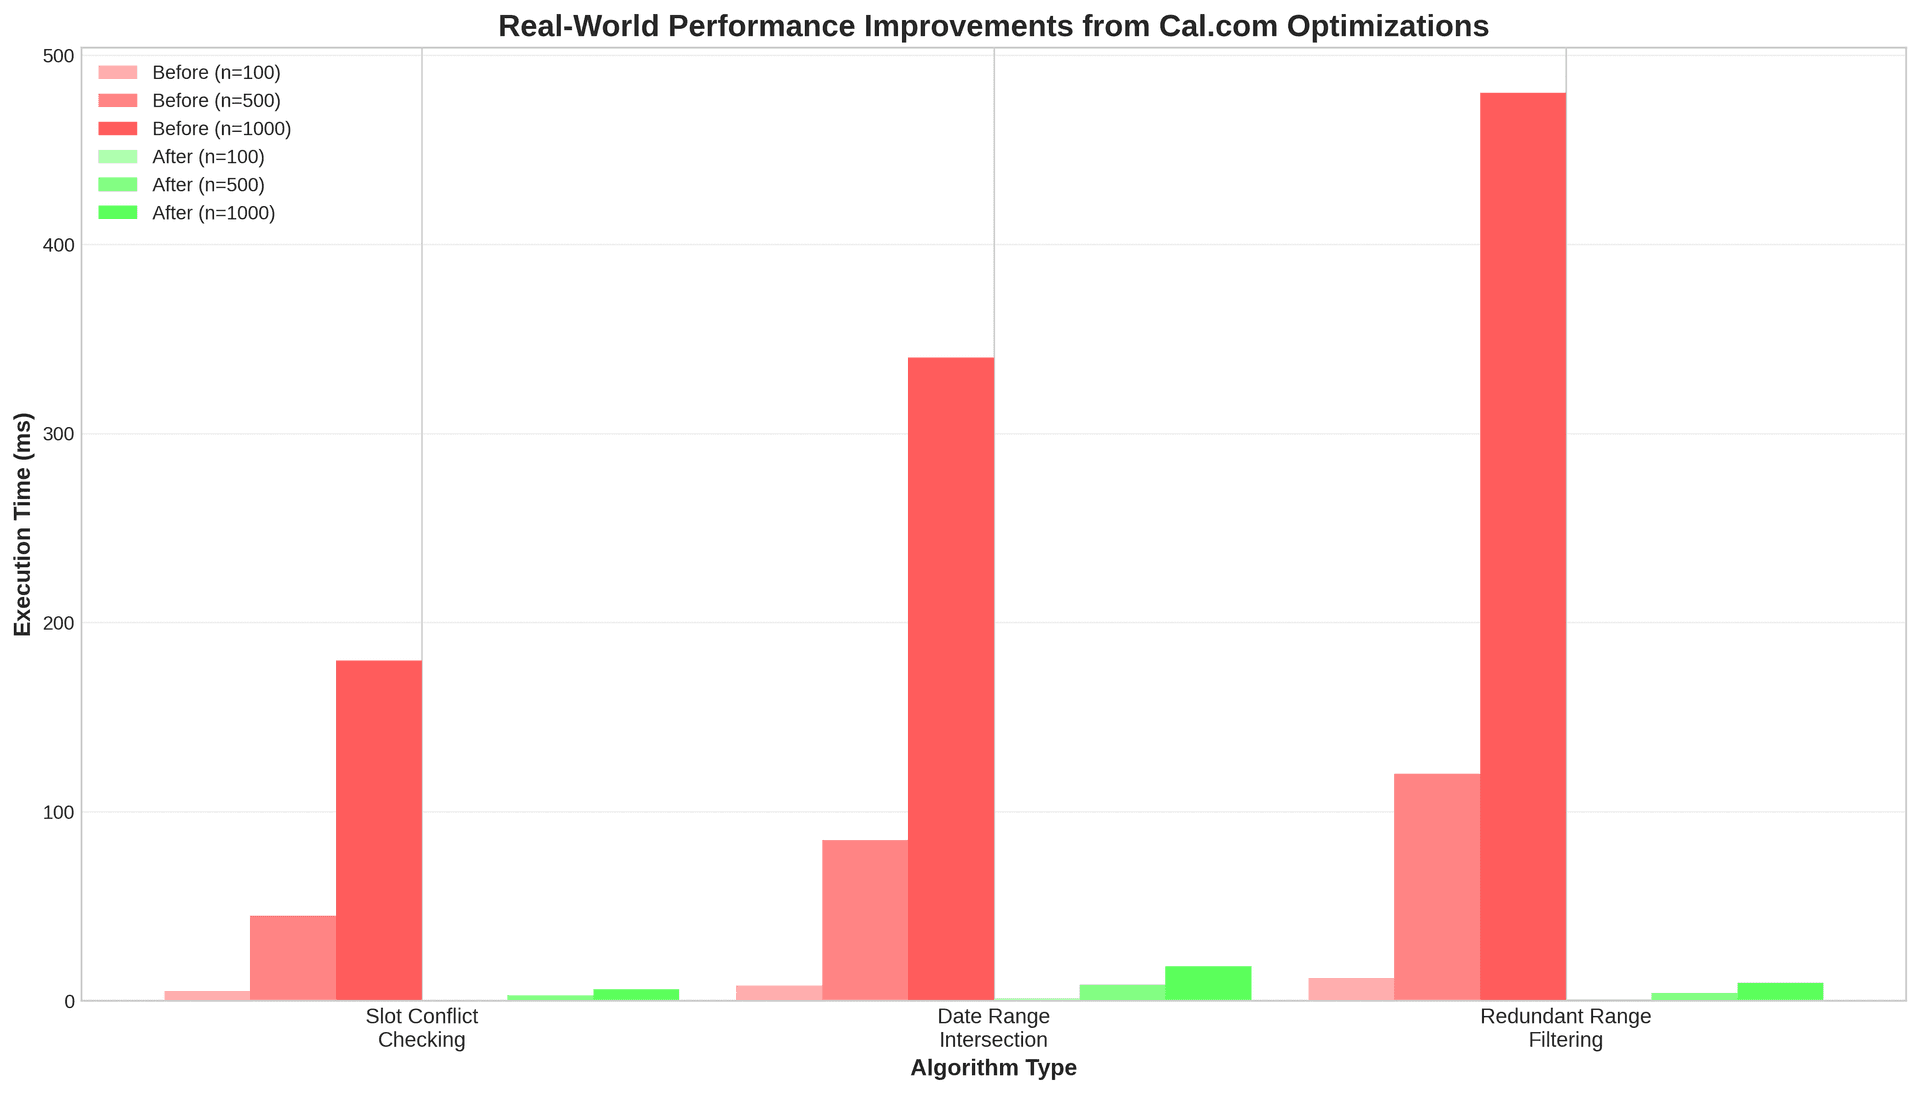
Nasze benchmarki pokazały znaczną poprawę:
-
Sprawdzanie konfliktów slotów: redukcja z O(n²) do O(n log n), co sprawiło, że 100 slotów i 50 okresów zajętości działało około dziesięć razy szybciej.
-
Przecięcie zakresów dat: spadek z O(n²) do O(n log n), co pozwoliło przetwarzać setki zakresów dat w milisekundach.
-
Filtrowanie zbędnych zakresów: redukcja z O(n²) do O(n log n), z przyspieszeniem nawet pięćdziesięciokrotnym dla tysięcy zakresów dat.
-
Ogólne przecięcie zakresów: w wielu wzorcach widzieliśmy poprawę rzędu dwudziestu pięciu razy lub więcej.

Łatwe techniki wykrywania algorytmów O(n²)
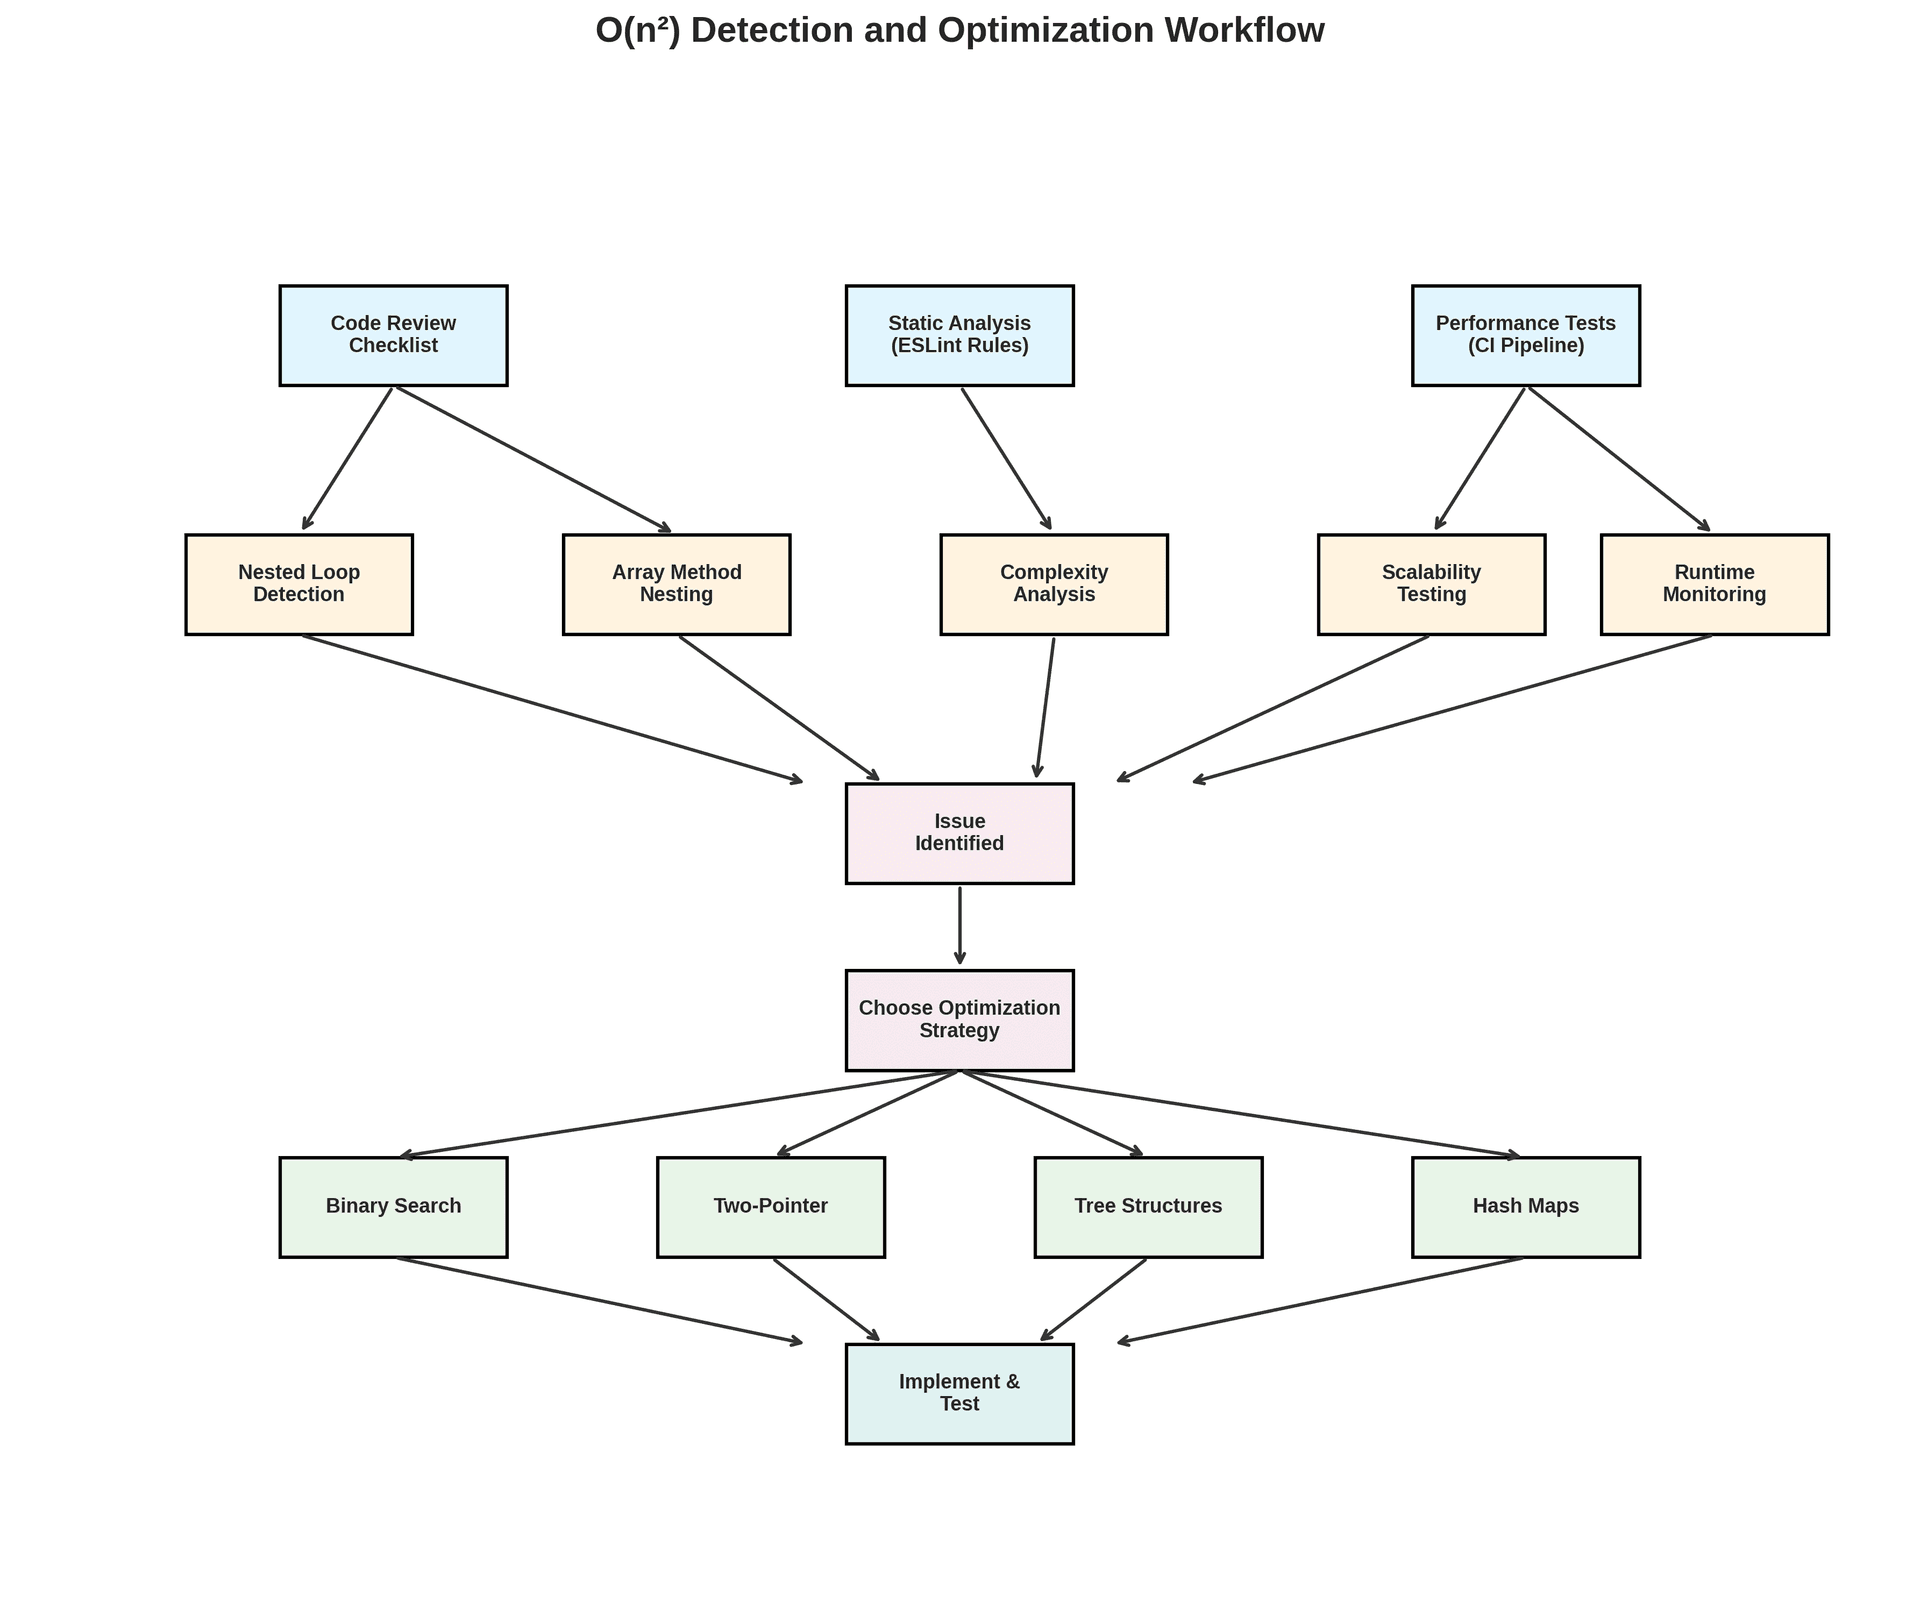
Rozpoznawaj wzorce problemów
Zwracaj uwagę na:
-
Zagnieżdżone iteracje po tablicach, zwłaszcza
.map,.forEach,.filterwewnątrz innej operacji. -
Metody tablicowe, takie jak
.some,.findlub.filter, użyte wewnątrz pętli albo callbacków tablicowych. -
Łańcuchowe filtrowanie lub zagnieżdżone mapowanie na dużych listach.
Testuj skalowalność wprost
Pisaj testy wydajności, które uruchamiają Twoją funkcję na danych o rosnącym rozmiarze i zapisują czasy wykonania. Jeśli czas rośnie kwadratowo wraz z rozmiarem danych, masz problem O(n²).
Automatyzuj analizę statyczną
Dodaj reguły lintowania lub analizę statyczną, które:
-
Oznaczają funkcje z zagnieżdżonymi pętlami lub zagnieżdżonymi metodami tablicowymi.
-
Wykrywają rekurencję bez memoizacji.
-
Wykrywają funkcje z wieloma zagnieżdżonymi wywołaniami
.some,.findlub.filter.
Sprawdzone strategie zastępowania kodu O(n²)
-
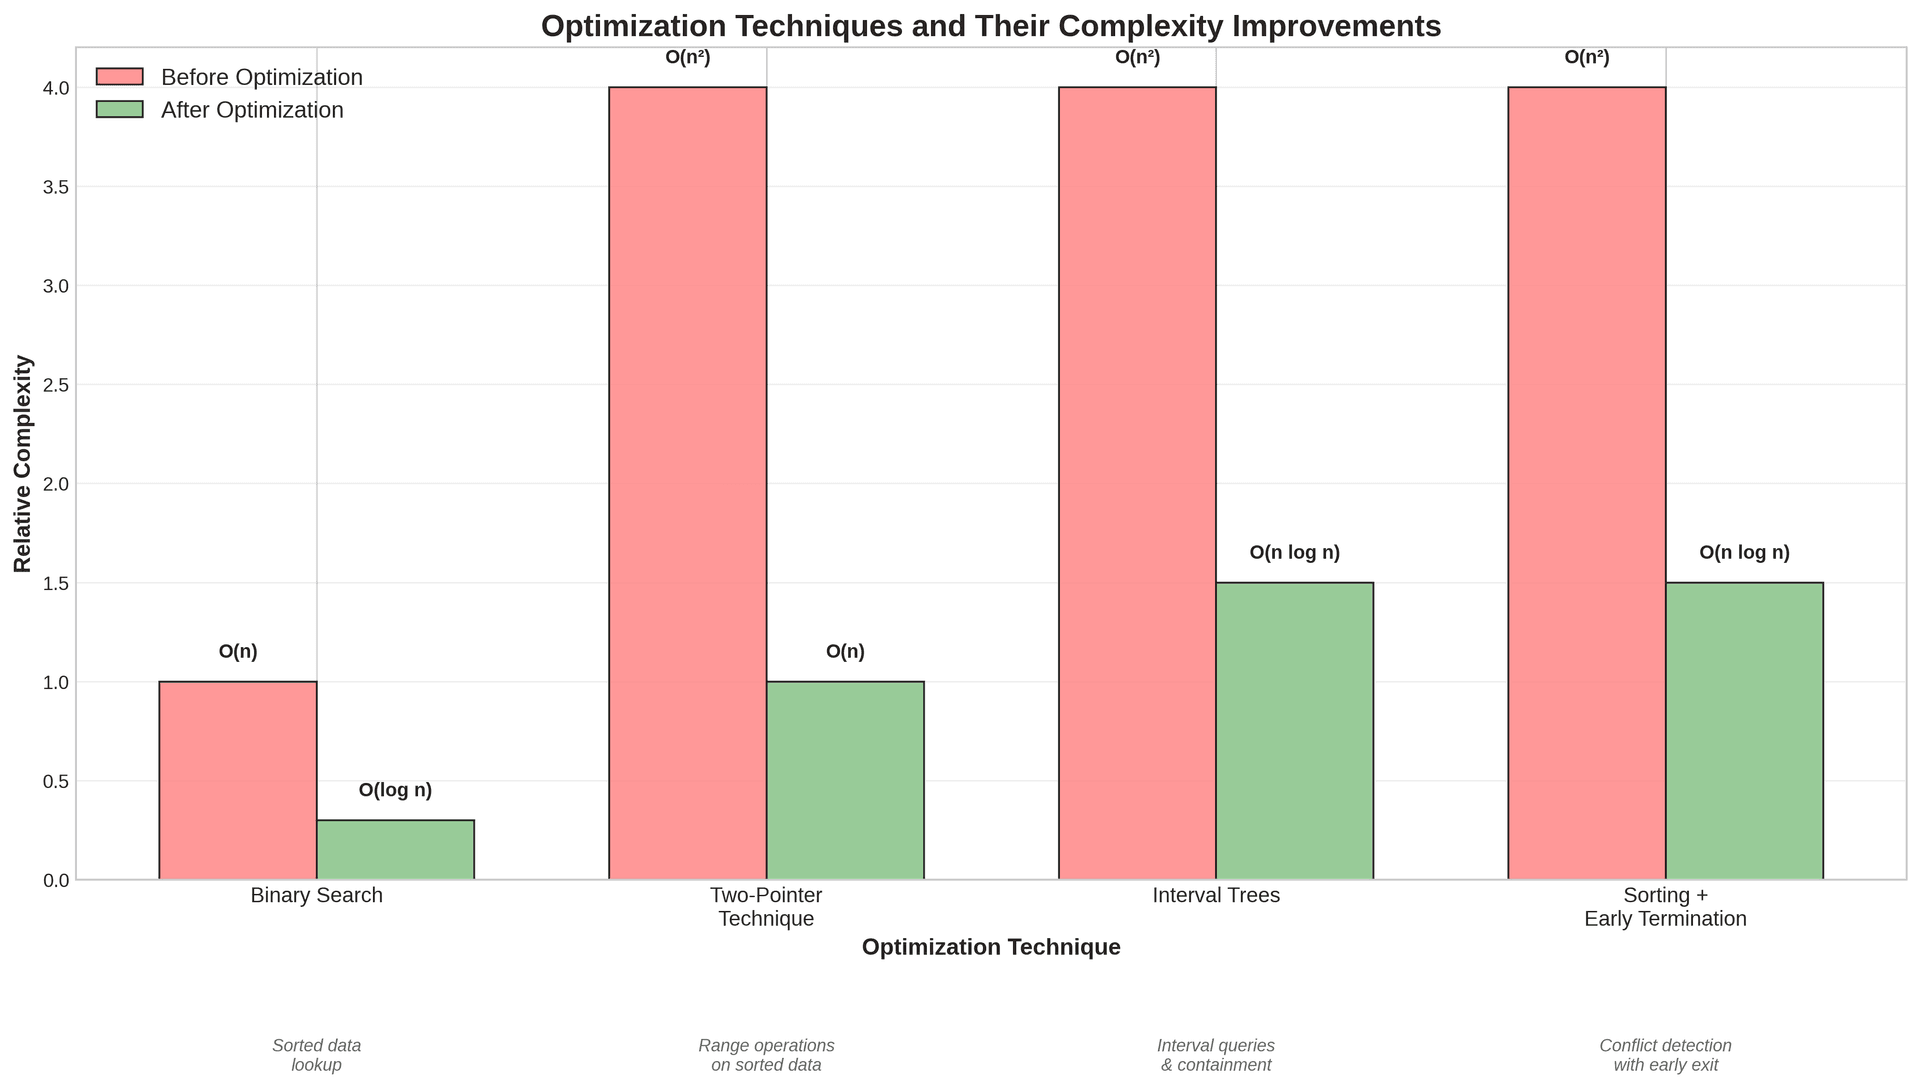
Używaj wyszukiwania binarnego do odwołań w posortowanych tablicach.
-
Używaj techniki dwóch wskaźników do łączenia lub przecinania posortowanych sekwencji.
-
Używaj struktur danych opartych na drzewach do zapytań o przedziały lub danych hierarchicznych.
Automatyzacja kontroli wydajności
Dodaj benchmarki wydajności do swojego pipeline’u CI, które uruchamiają krytyczne algorytmy na realistycznych danych. Porównuj czasy wykonania przy każdym pull requeście i blokuj mergowanie regresji. Dodaj własne reguły lintowania, aby oczywiste wzorce O(n²) nigdy nie trafiały na produkcję. Wdróż monitorowanie czasu działania dla krytycznych ścieżek, aby wychwytywać nowe regresje, zanim zauważą je użytkownicy.
Najważniejsze wnioski
-
Zapobieganie jest zawsze lepsze niż leczenie. Automatyczne kontrole wyłapią algorytmy O(n²), zanim sprawią kłopoty.
-
Zawsze profiluj, zanim zoptymalizujesz. Używaj testów, aby znaleźć rzeczywiste wąskie gardła.
-
Dobieraj odpowiednie struktury danych do swoich potrzeb. Posortowane tablice, podejście dwuwskaźnikowe i drzewa są bezcenne.
-
Testuj na realistycznych danych w dużej skali. Małe testy mogą ukrywać duże problemy.
-
Monitoruj w produkcji. Automatyczne alerty mogą wcześnie wykryć regresje.
Zakończenie
Optymalizacje, które wprowadziliśmy w Cal.com, pokazują, że znaczące zyski wydajności są możliwe dzięki zastosowaniu sprawdzonych technik algorytmicznych. Połącz code review, inteligentne struktury danych i automatyczne monitorowanie, aby Twoja aplikacja pozostała szybka wraz ze wzrostem skali.
Wydajność powinna być uwzględniana na każdym etapie tworzenia oprogramowania — od code review, które wyłapuje podejrzane wzorce, przez pipeline’y CI uruchamiające testy skalowalności, po monitorowanie czasu działania wykrywające regresje.
Dzisiejszy szybki algorytm jutro może łatwo stać się wąskim gardłem, gdy Twoje dane urosną. Zachowaj czujność, testuj na dużej skali i zawsze bądź gotowy do optymalizacji.