Encontrando e corrigindo gargalos de desempenho O(n²): lições das otimizações de algoritmo da Cal.com
Um mergulho profundo em como detectamos, analisamos e otimizamos algoritmos de baixo desempenho em uma base de código real de produção.

On this page
- Introdução
- O problema: como código inocente se torna O(n²)
- Estudo de caso 1: otimização da verificação de conflito de slots
- O problema original
- Implementação original: loops aninhados O(n²)
- Implementação otimizada: O(n log n) com ordenação e saída antecipada
- Estudo de caso 2: interseção de intervalo de datas usando a técnica de dois ponteiros
- O problema original
- Implementação original: mapeamento aninhado O(n²)
- Implementação otimizada: O(n log n) com travessia de dois ponteiros
- Estudo de caso 3: árvore de intervalos para filtragem de intervalos redundantes
- O problema original
- Implementação original: verificação de contenção O(n²)
- Implementação otimizada: O(n log n) com uma árvore de intervalos
- Resultados de desempenho: antes e depois
- Técnicas fáceis para detectar algoritmos O(n²)
- Reconheça padrões problemáticos
- Teste explicitamente a escalabilidade
- Automatize a análise estática
- Estratégias comprovadas para substituir código O(n²)
- Automatizando verificações de desempenho
- Principais conclusões
- Conclusão
Introdução
Gargalos de desempenho em sistemas de agendamento podem ser a diferença entre uma experiência de usuário responsiva e usuários abandonando sua plataforma por frustração. Na Cal.com, recentemente descobrimos e otimizamos vários algoritmos críticos O(n²) que causavam lentidão à medida que nossa base de usuários e o volume de dados cresciam.
Neste artigo, vou compartilhar quatro otimizações reais de algoritmo da base de código da Cal.com. Você vai aprender como detectamos a complexidade O(n²), quais estratégias de otimização funcionaram melhor e como colocamos verificações automatizadas em prática para evitar regressões futuras.
O problema: como código inocente se torna O(n²)
À medida que plataformas de agendamento crescem, é surpreendentemente fácil que loops aninhados aparentemente inocentes se tornem assassinos silenciosos de desempenho. Considere este exemplo real da nossa base de código:
// O(n²): Every available slot is checked against every busy period
availableTimeSlots.map(slot => {
  return busy.some(busyTime => checkOverlap(slot, busyTime));
});
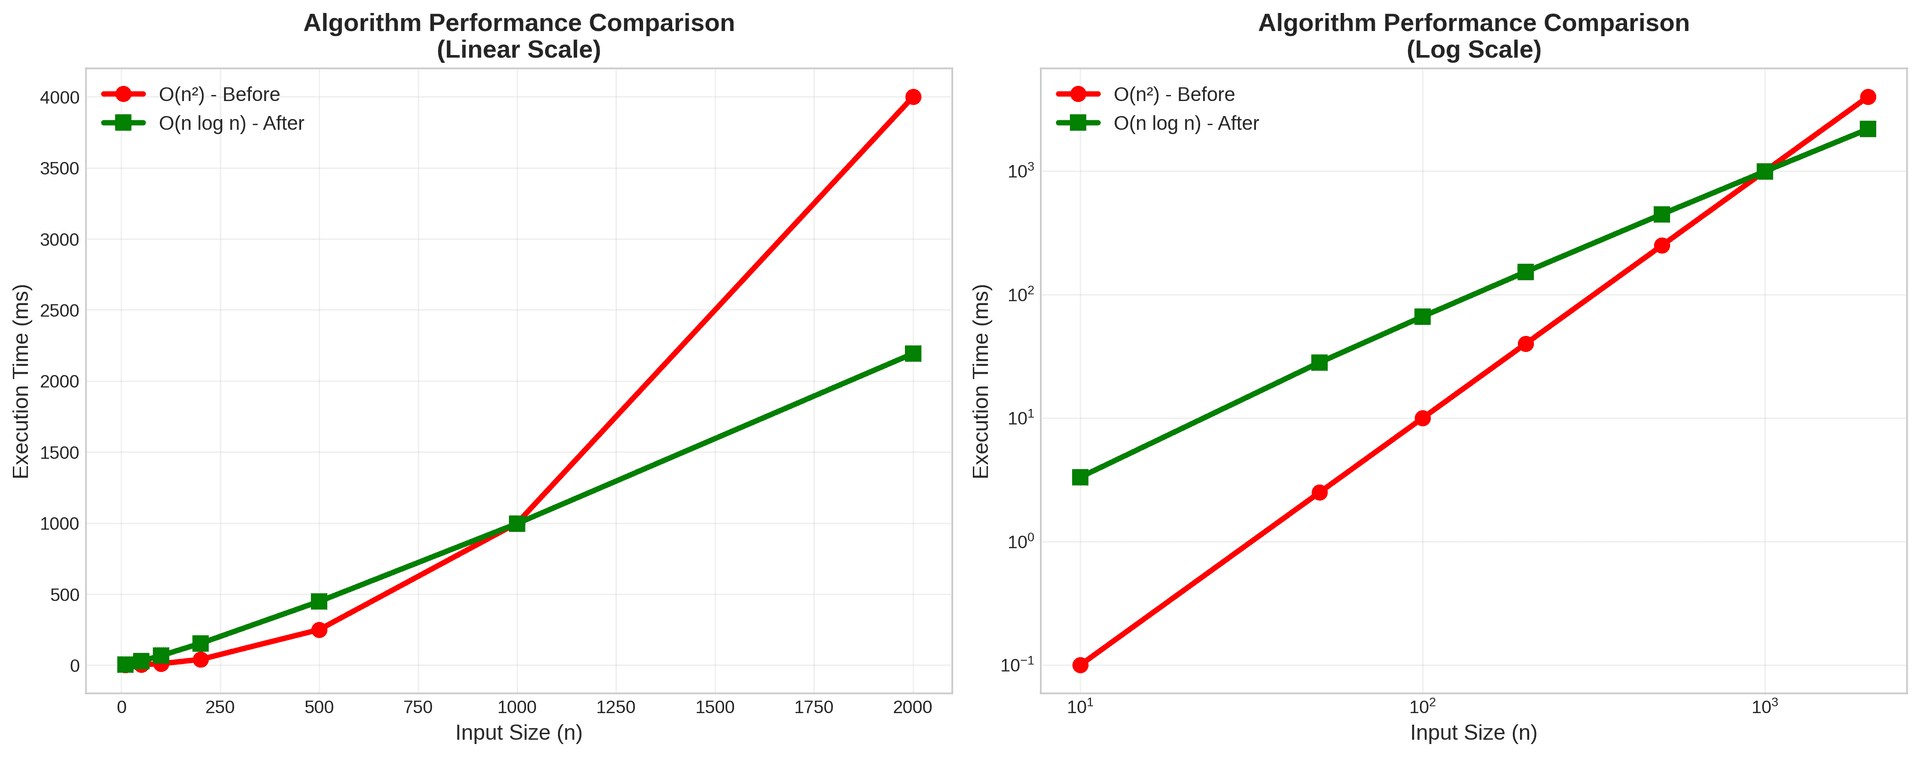
Para 100 slots e 50 períodos ocupados, isso dá 5.000 verificações de sobreposição. Em escalas maiores — 500 slots e 200 períodos ocupados — isso explode para 100.000 operações. Isso representa um aumento de vinte vezes na carga computacional para apenas um aumento de cinco vezes nos dados.
Estudo de caso 1: otimização da verificação de conflito de slots
O problema original
A função checkForConflicts usava iteração aninhada para verificar se os slots de booking conflitavam com períodos ocupados. Isso rapidamente se tornou um problema de desempenho com agendas grandes.
Implementação original: loops aninhados O(n²)
function checkForConflicts({ busy, time, eventLength }) {
  return busy.some(busyTime => {
    const slotStart = time.valueOf();
    const slotEnd = slotStart + eventLength * 60 * 1000;
    const busyStart = dayjs.utc(busyTime.start).valueOf();
    const busyEnd = dayjs.utc(busyTime.end).valueOf();
    return !(busyEnd <= slotStart || busyStart >= slotEnd);
  });
}

availableTimeSlots = availableTimeSlots
  .map((slot) => {
    if (
      !checkForConflicts({
        time: slot.time,
        busy: busySlotsFromReservedSlots,
        ...availabilityCheckProps,
      })
    ) {
      return slot;
    }
    return undefined;
  })
Implementação otimizada: O(n log n) com ordenação e saída antecipada
function checkForConflicts({ sortedBusyTimes, time, eventLength }) {
  const slotStart = time.valueOf();
  const slotEnd = slotStart + eventLength * 60 * 1000;

  for (const busyTime of sortedBusyTimes) {
    if (busyTime.start >= slotEnd) {
      break;
    }
    if (busyTime.end <= slotStart) {
      continue;
    }
    return true;
  }
  return false;
}
O que mudou:
Ordenamos os horários ocupados pelos seus horários de início, o que nos permitiu pular períodos sem sobreposição e sair cedo quando nenhum conflito era possível. O resultado foi uma queda drástica no número de comparações desnecessárias.
Impacto:
A complexidade caiu de O(slots disponíveis × períodos ocupados) para O(n log n), e na maioria dos casos as verificações foram puladas por completo.
Estudo de caso 2: interseção de intervalo de datas usando a técnica de dois ponteiros
O problema original
A função intersect antes usava loops aninhados para encontrar sobreposições entre a disponibilidade de vários usuários.
Implementação original: mapeamento aninhado O(n²)
commonAvailability.forEach(commonRange => {
  userRanges.forEach(userRange => {
    const intersection = getIntersection(commonRange, userRange);
    if (intersection !== null) {
      intersectedRanges.push(intersection);
    }
  });
});
Implementação otimizada: O(n log n) com travessia de dois ponteiros
const sortedRanges = ranges.map(userRanges =>
  userRanges
    .map(r => ({
      ...r,
      startValue: r.start.valueOf(),
      endValue: r.end.valueOf()
    }))
    .sort((a, b) => a.startValue - b.startValue)
);

let commonIndex = 0;
let userIndex = 0;

while (commonIndex < commonAvailability.length && userIndex < userRanges.length) {
  const commonRange = commonAvailability[commonIndex];
  const userRange = userRanges[userIndex];

  const intersectStartValue = Math.max(commonRange.startValue, userRange.startValue);
  const intersectEndValue = Math.min(commonRange.endValue, userRange.endValue);

  if (intersectStartValue < intersectEndValue) {
    intersectedRanges.push(createIntersection(commonRange, userRange));
  }

  if (commonRange.endValue <= userRange.endValue) {
    commonIndex++;
  } else {
    userIndex++;
  }
}
O que mudou:
Ao ordenar e usar dois ponteiros para percorrer os intervalos, eliminamos a necessidade de iteração aninhada. Isso reduziu a complexidade de quadrática para quase linear na maioria das entradas práticas.
Estudo de caso 3: árvore de intervalos para filtragem de intervalos redundantes
O problema original
A função filterRedundantDateRanges verificava cada intervalo contra todos os outros para ver se um continha o outro. Para agendas grandes, isso ficou dolorosamente lento.
Implementação original: verificação de contenção O(n²)
return dateRanges.filter((range, index) => {
  return !dateRanges.some((otherRange, otherIndex) => {
    if (index === otherIndex) return false;
    return isCompletelyContained(range, otherRange);
  });
});
Implementação otimizada: O(n log n) com uma árvore de intervalos
export function filterRedundantDateRanges(dateRanges) {
  const sortedRanges = [...dateRanges].sort((a, b) => a.start.valueOf() - b.start.valueOf());
  const intervalNodes = createIntervalNodes(
    sortedRanges,
    (range) => range.start.valueOf(),
    (range) => range.end.valueOf()
  );
  const intervalTree = new IntervalTree(intervalNodes);
  const searchAlgorithm = new ContainmentSearchAlgorithm(intervalTree);

  return sortedRanges.filter((range, index) => {
    const containingIntervals = searchAlgorithm.findContainingIntervals(
      range.start.valueOf(),
      range.end.valueOf(),
      index
    );
    return containingIntervals.length === 0;
  });
}
O que mudou:
Em vez de comparação na força bruta, usamos uma estrutura de árvore de intervalos para permitir consultas de contenção rápidas em O(log n). Essa é uma abordagem clássica em geometria computacional que funciona muito bem para aplicações de agendamento.
Resultados de desempenho: antes e depois
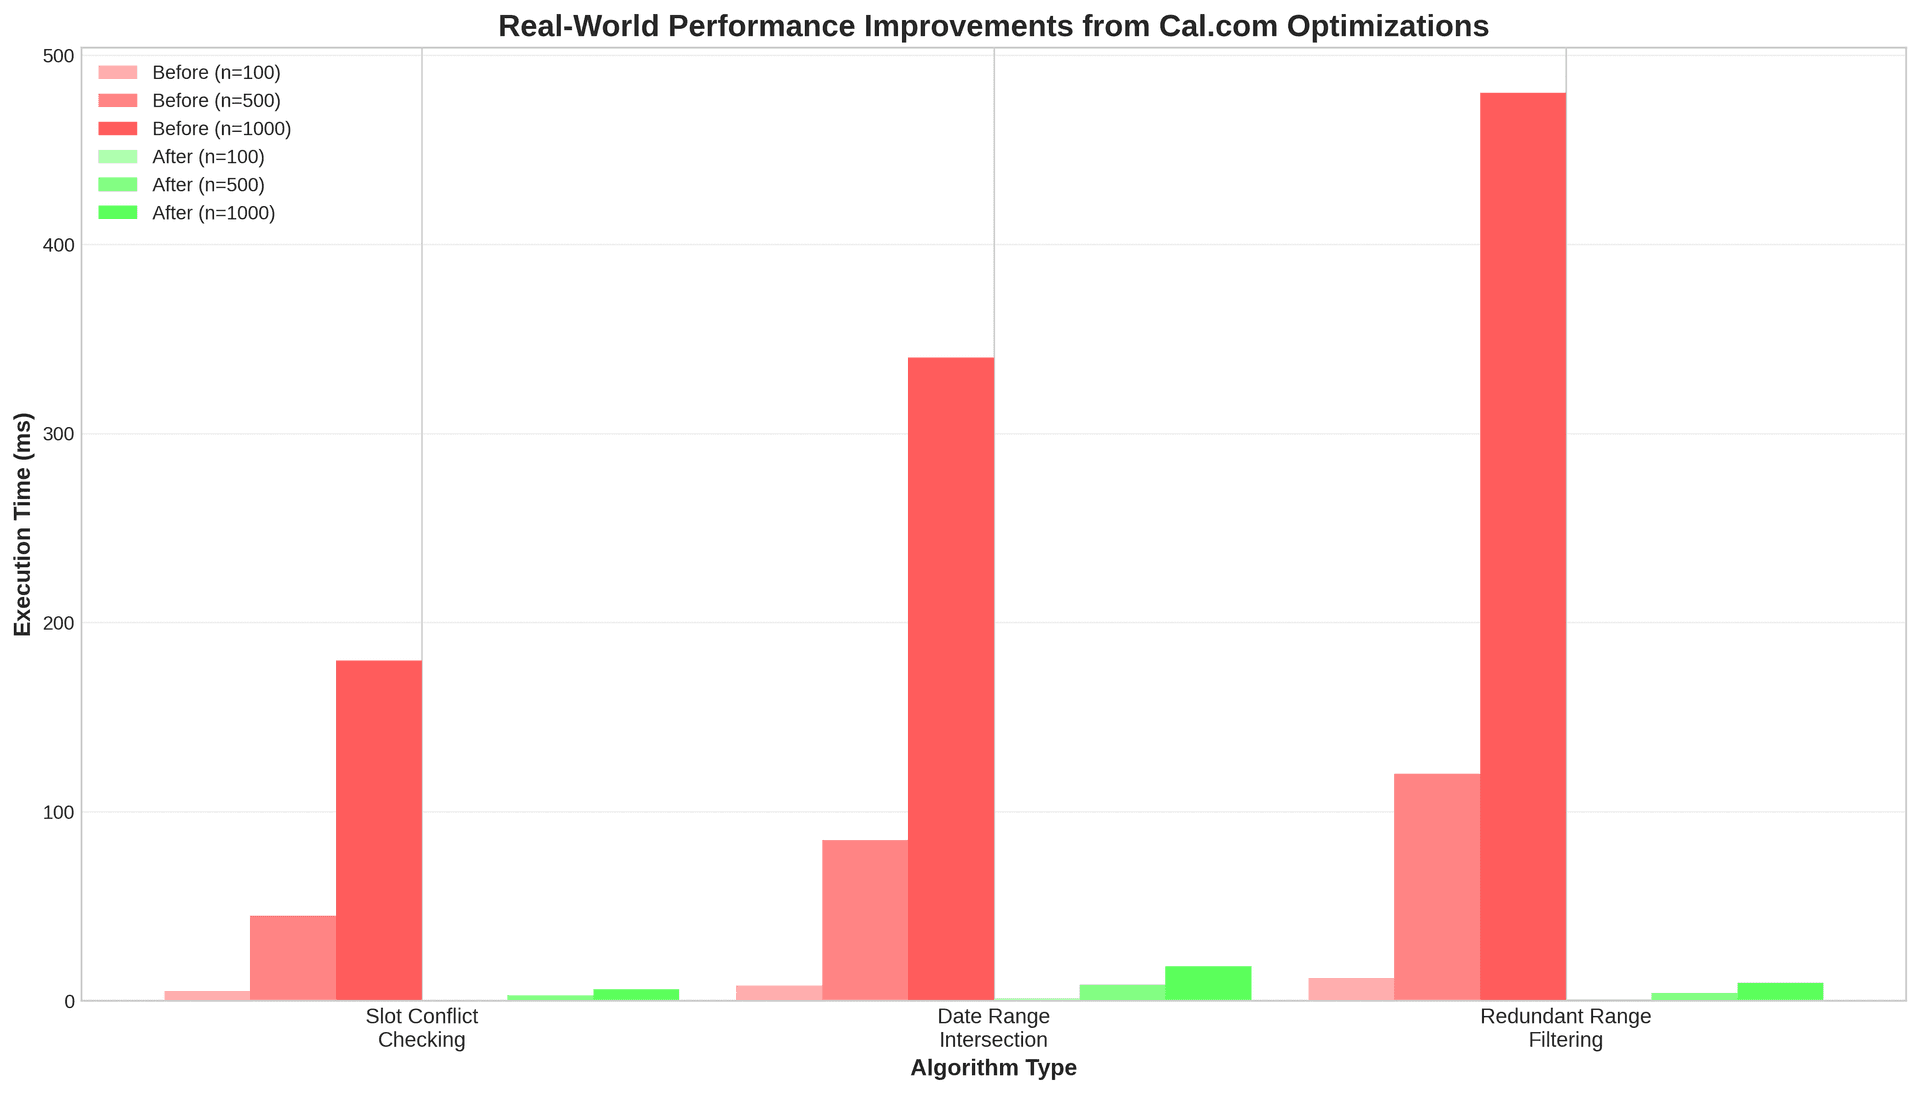
Nossos benchmarks mostraram melhorias significativas:
-
Verificação de conflito de slots: reduzida de O(n²) para O(n log n), tornando 100 slots e 50 períodos ocupados cerca de dez vezes mais rápido.
-
Interseção de intervalo de datas: caiu de O(n²) para O(n log n), permitindo processar centenas de intervalos de datas em milissegundos.
-
Filtragem de intervalos redundantes: reduzida de O(n²) para O(n log n), com aceleração de até cinquenta vezes para milhares de intervalos de datas.
-
Interseção geral de intervalos: em muitos padrões, vimos melhorias de vinte e cinco vezes ou mais.

Técnicas fáceis para detectar algoritmos O(n²)
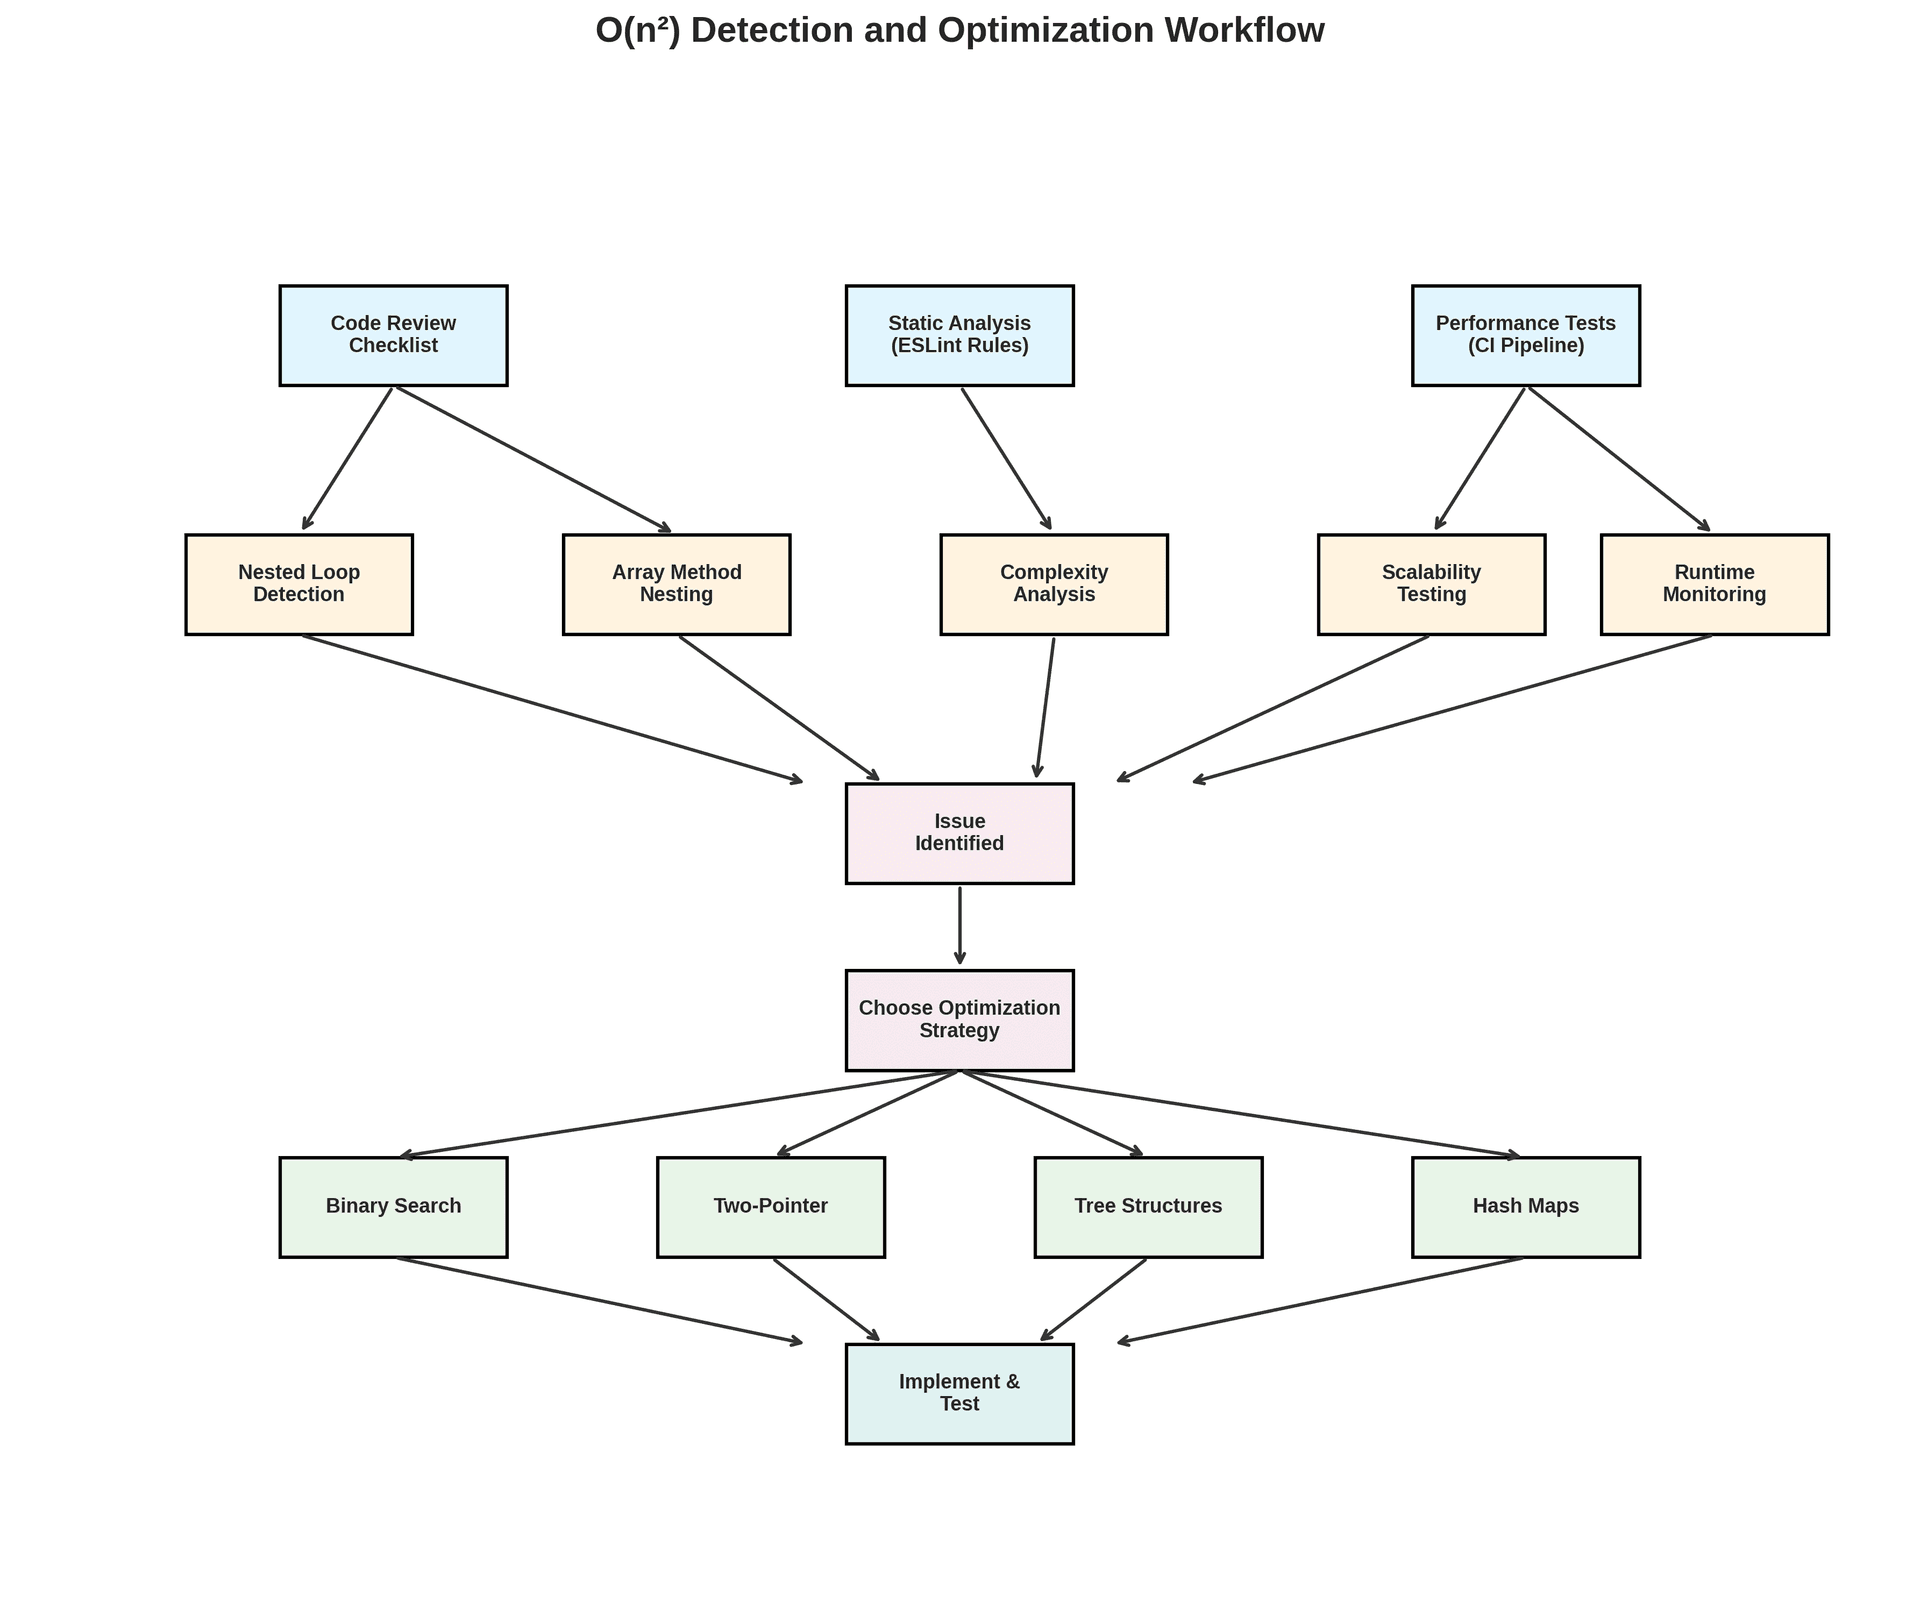
Reconheça padrões problemáticos
Fique de olho em:
-
Iterações aninhadas em arrays, especialmente
.map,.forEach,.filterdentro de outro. -
Métodos de array como
.some,.findou.filterdentro de loops ou callbacks de array. -
Filtros encadeados ou mapeamento aninhado em listas grandes.
Teste explicitamente a escalabilidade
Escreva testes de desempenho que executem sua função com dados de tamanho crescente e registrem os tempos de execução. Se o tempo crescer quadraticamente com o tamanho dos dados, você tem um problema O(n²).
Automatize a análise estática
Adicione regras de lint ou análise estática que:
-
Marquem funções com loops aninhados ou métodos de array aninhados.
-
Identifiquem recursão sem memoização.
-
Detectem funções com múltiplas chamadas aninhadas de
.some,.findou.filter.
Estratégias comprovadas para substituir código O(n²)
-
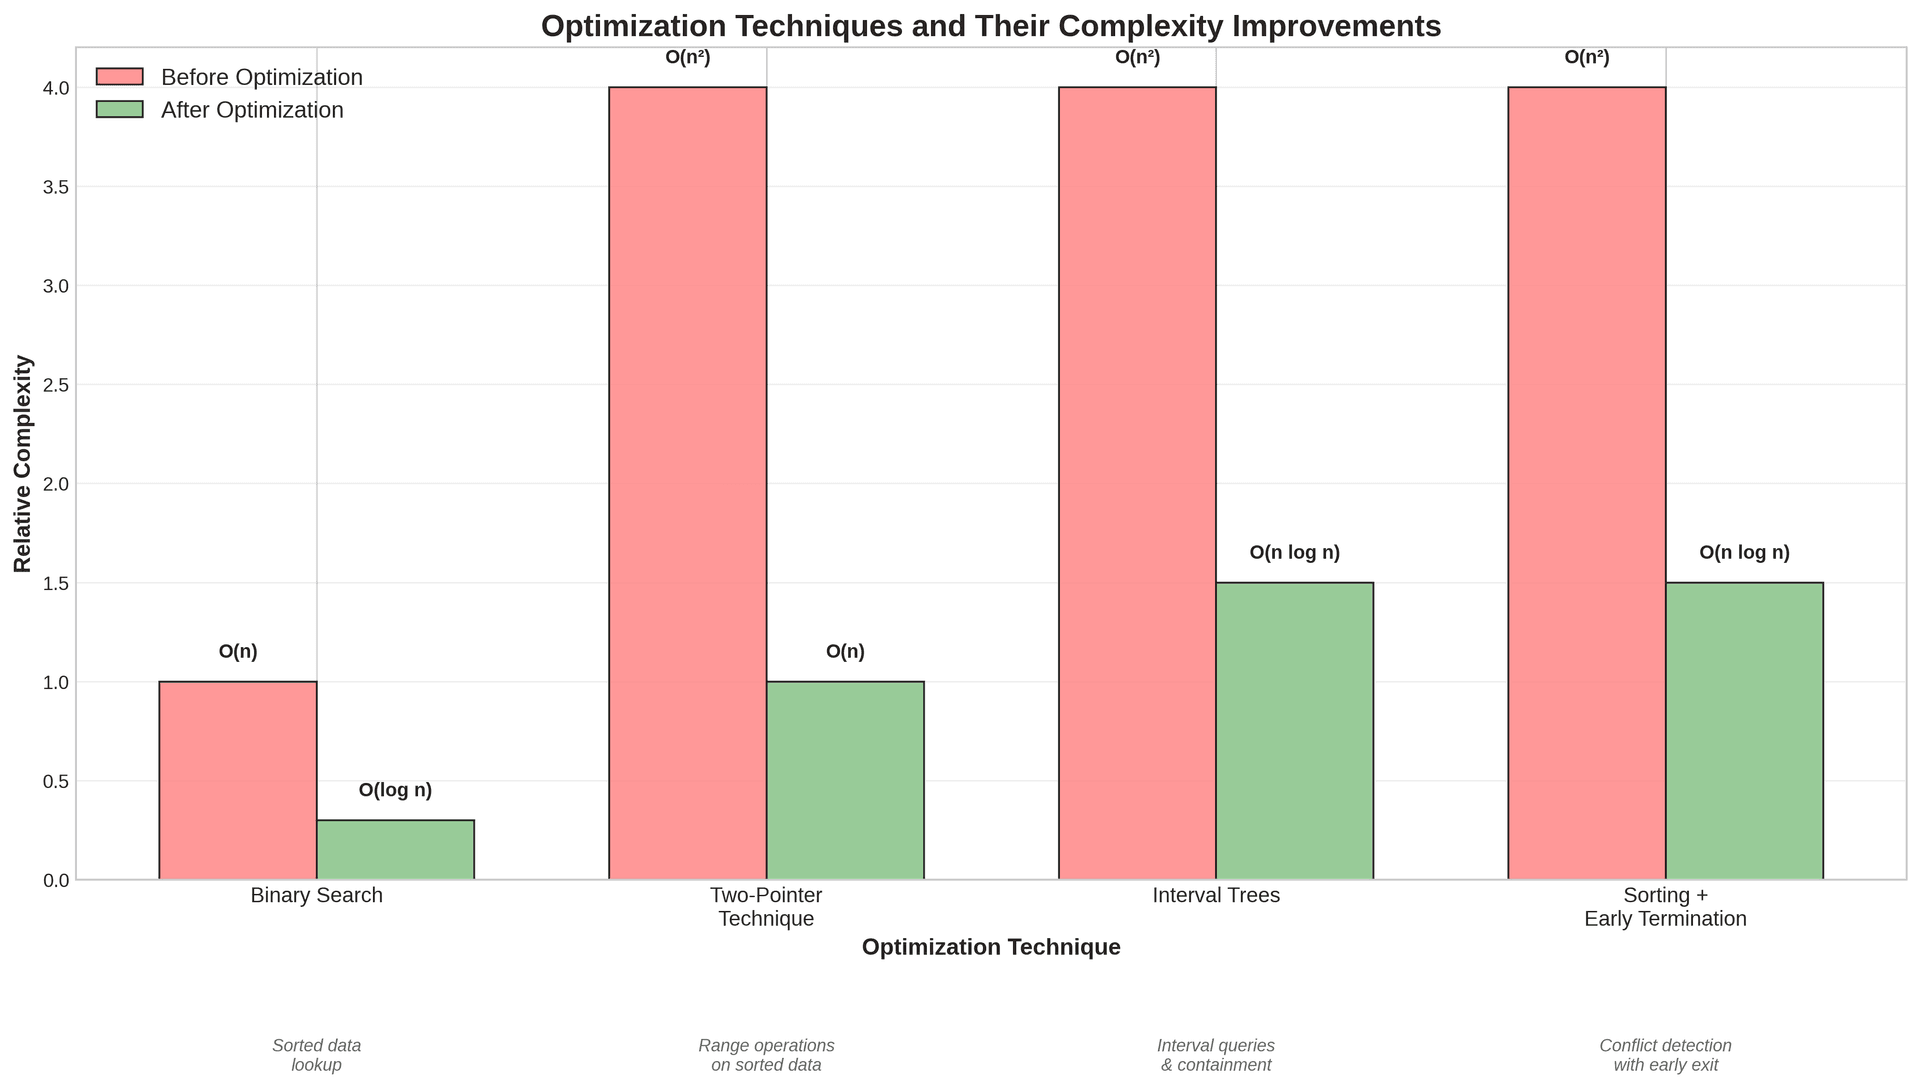
Use busca binária para consultas em arrays ordenados.
-
Use técnicas de dois ponteiros para mesclar ou intersectar sequências ordenadas.
-
Use estruturas de dados baseadas em árvore para consultas de intervalo ou dados hierárquicos.
Automatizando verificações de desempenho
Adicione benchmarks de desempenho ao seu pipeline de CI para executar algoritmos críticos com dados realistas. Compare os tempos de execução em cada pull request e bloqueie merges que tragam regressões. Adicione regras de lint personalizadas para impedir que padrões O(n²) óbvios cheguem à produção. Implemente monitoramento em tempo de execução para caminhos críticos, a fim de detectar novas regressões antes que os usuários percebam.
Principais conclusões
-
Prevenir é sempre melhor do que remediar. Verificações automatizadas vão pegar algoritmos O(n²) antes que eles causem problemas.
-
Sempre faça profiling antes de otimizar. Use testes para encontrar os gargalos reais.
-
Escolha as estruturas de dados certas para suas necessidades. Arrays ordenados, abordagens de dois ponteiros e árvores são valiosos.
-
Teste com dados realistas e em grande escala. Testes pequenos podem esconder problemas grandes.
-
Monitore em produção. Alertas automatizados podem detectar regressões cedo.
Conclusão
As otimizações que fizemos na Cal.com mostram que ganhos significativos de desempenho são possíveis ao aplicar técnicas algorítmicas comprovadas. Combine revisão de código, estruturas de dados inteligentes e monitoramento automatizado para manter sua aplicação rápida conforme ela escala.
O desempenho deve ser incorporado em todas as etapas do desenvolvimento, desde revisões de código que sinalizam padrões suspeitos até pipelines de CI que executam testes de escalabilidade e monitoramento em tempo de execução que detecta regressões.
Hoje, um algoritmo rápido pode facilmente se tornar o gargalo de amanhã à medida que seus dados crescem. Fique atento, teste em escala e esteja sempre pronto para otimizar.