Encontrar y arreglar cuellos de botella de rendimiento O(n²): lecciones de las optimizaciones de algoritmos de Cal.com
Un análisis en profundidad de cómo detectamos, analizamos y optimizamos algoritmos de bajo rendimiento en una base de código real en producción.

On this page
- Introducción
- El problema: cómo un código inocente se convierte en O(n²)
- Caso práctico 1: optimización de la comprobación de conflictos de huecos
- El problema original
- Implementación original: bucles anidados O(n²)
- Implementación optimizada: O(n log n) con ordenación y salida anticipada
- Caso práctico 2: intersección de rangos de fechas usando la técnica de dos punteros
- El problema original
- Implementación original: mapeado anidado O(n²)
- Implementación optimizada: O(n log n) con recorrido de dos punteros
- Caso práctico 3: árbol de intervalos para filtrar rangos redundantes
- El problema original
- Implementación original: comprobación de contención O(n²)
- Implementación optimizada: O(n log n) con un árbol de intervalos
- Resultados de rendimiento: antes y después
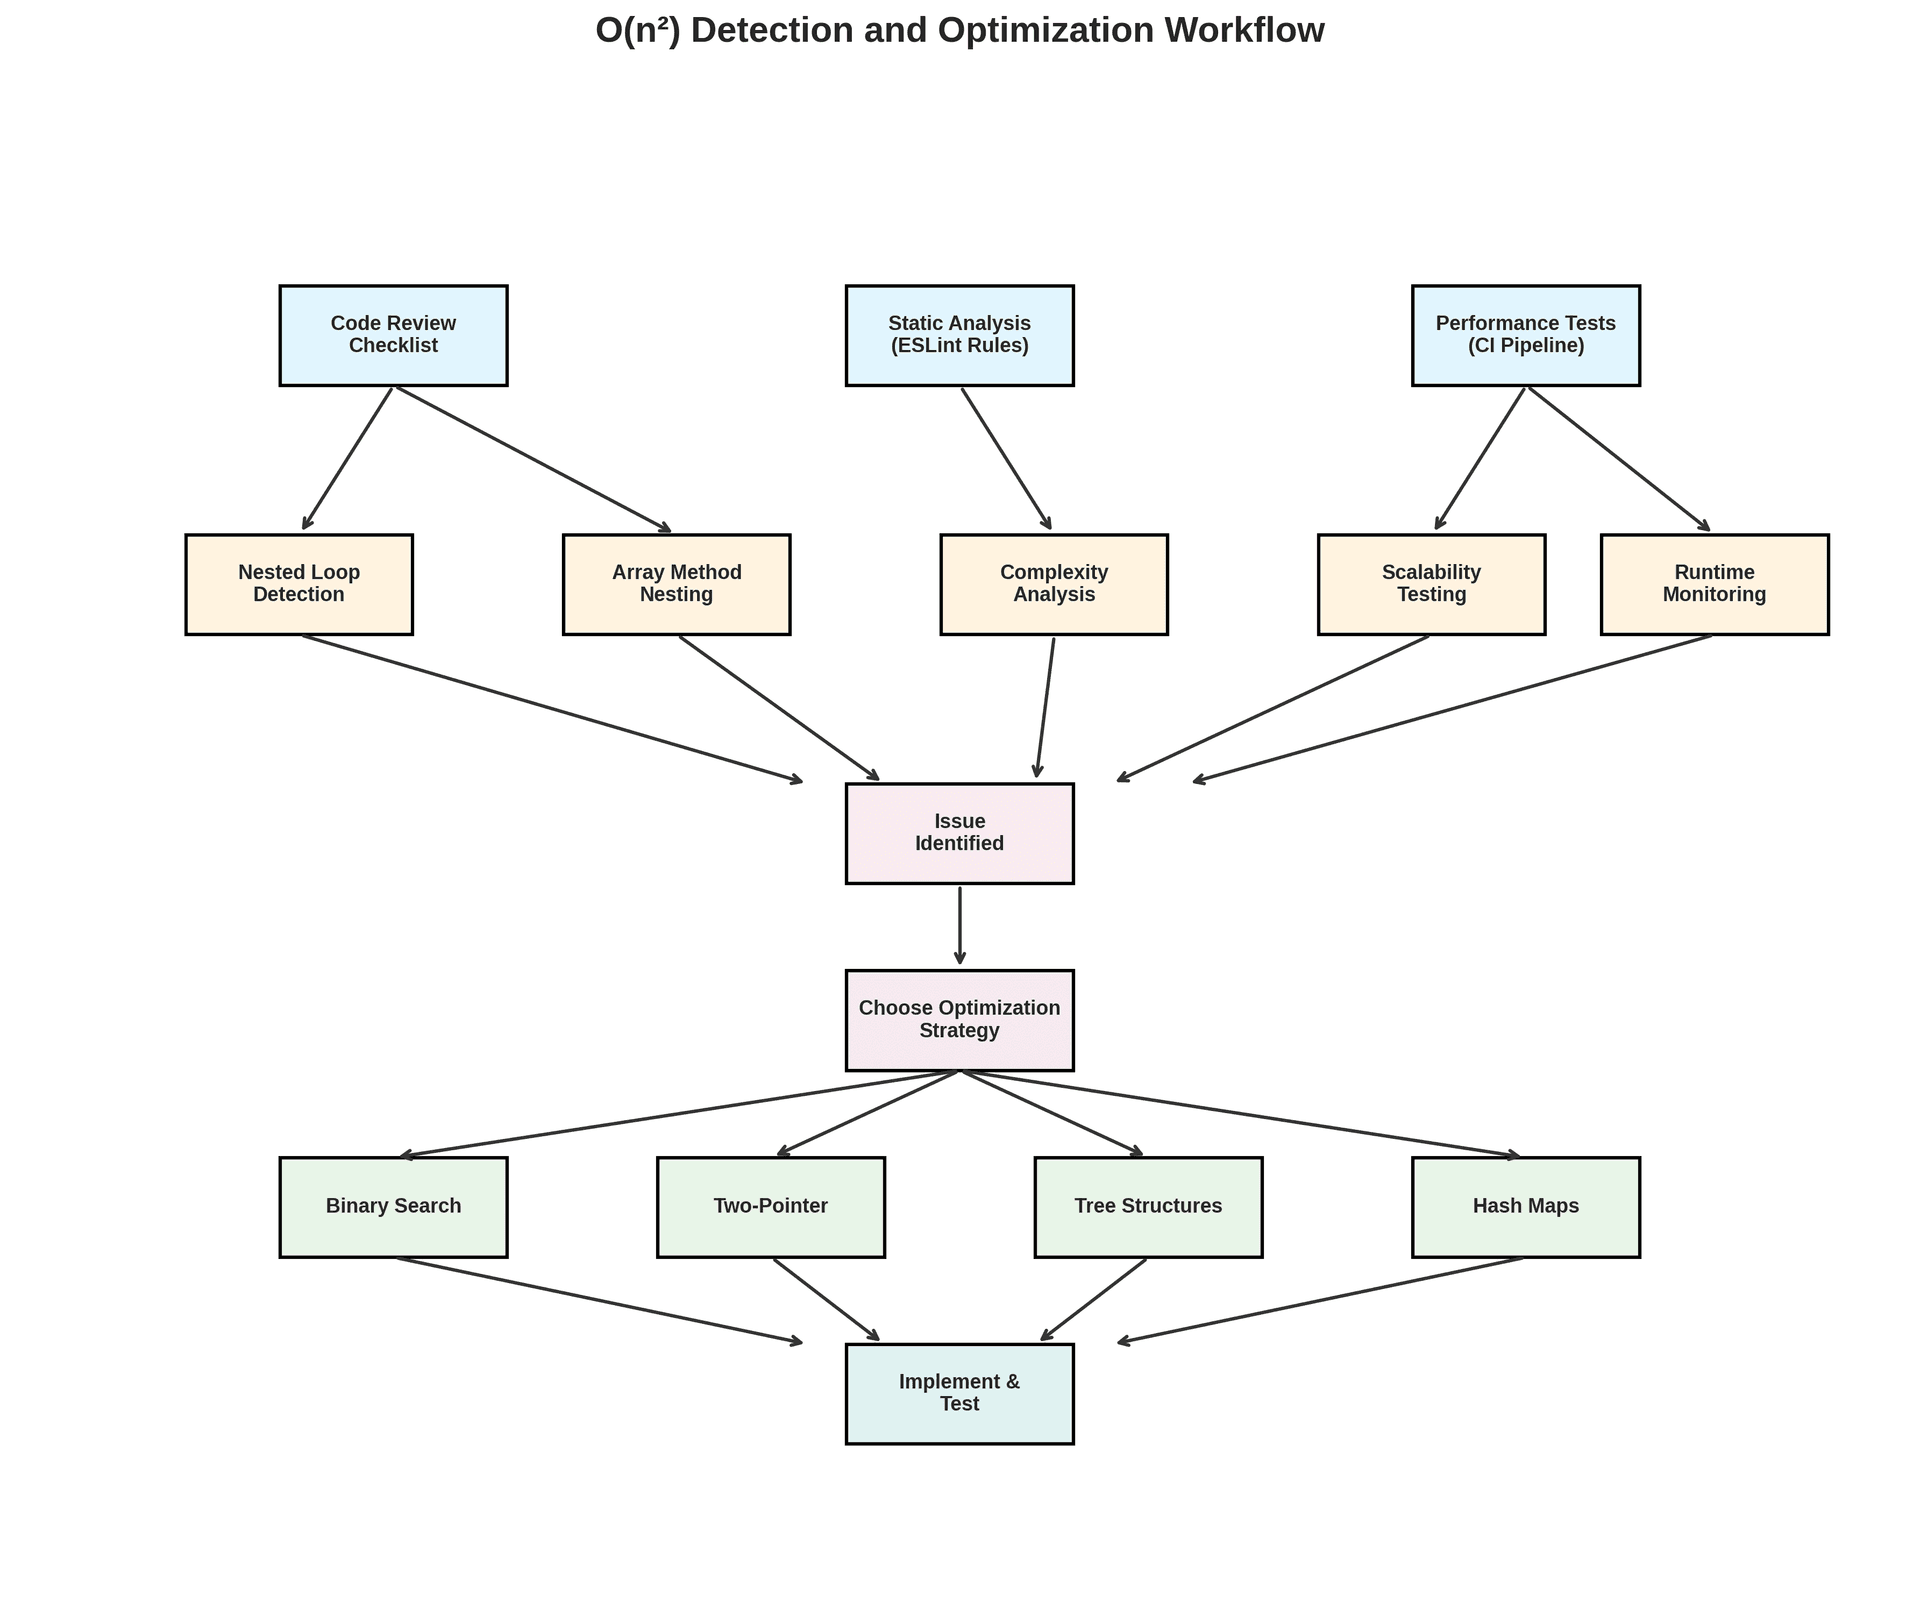
- Técnicas sencillas para detectar algoritmos O(n²)
- Reconoce patrones problemáticos
- Prueba explícitamente la escalabilidad
- Automatiza el análisis estático
- Estrategias probadas para sustituir código O(n²)
- Automatizar las comprobaciones de rendimiento
- Conclusiones clave
- Conclusión
Introducción
Los cuellos de botella de rendimiento en sistemas de programación pueden marcar la diferencia entre una experiencia de usuario ágil y que la gente abandone tu plataforma por frustración. En Cal.com, recientemente detectamos y optimizamos varios algoritmos O(n²) críticos que estaban provocando lentitud a medida que crecían nuestra base de usuarios y los volúmenes de datos.
En este artículo compartiré cuatro optimizaciones reales de algoritmos de la base de código de Cal.com. Aprenderás cómo detectamos la complejidad O(n²), qué estrategias de optimización funcionaron mejor y cómo pusimos en marcha comprobaciones automatizadas para evitar regresiones futuras.
El problema: cómo un código inocente se convierte en O(n²)
A medida que crecen las plataformas de programación, es sorprendentemente fácil que unos bucles anidados aparentemente inocentes se conviertan en asesinos silenciosos del rendimiento. Considera este ejemplo real de nuestra base de código:
// O(n²): Every available slot is checked against every busy period
availableTimeSlots.map(slot => {
  return busy.some(busyTime => checkOverlap(slot, busyTime));
});
Para 100 huecos y 50 periodos ocupados, eso supone 5.000 comprobaciones de solapamiento. A mayor escala —500 huecos y 200 periodos ocupados— se dispara hasta 100.000 operaciones. Es un aumento de veinte veces en la carga computacional por solo un aumento de cinco veces en los datos.
Caso práctico 1: optimización de la comprobación de conflictos de huecos
El problema original
La función checkForConflicts usaba iteración anidada para comprobar si los huecos de reserva entraban en conflicto con periodos ocupados. Esto se convirtió rápidamente en un problema de rendimiento con agendas grandes.
Implementación original: bucles anidados O(n²)
function checkForConflicts({ busy, time, eventLength }) {
  return busy.some(busyTime => {
    const slotStart = time.valueOf();
    const slotEnd = slotStart + eventLength * 60 * 1000;
    const busyStart = dayjs.utc(busyTime.start).valueOf();
    const busyEnd = dayjs.utc(busyTime.end).valueOf();
    return !(busyEnd <= slotStart || busyStart >= slotEnd);
  });
}

availableTimeSlots = availableTimeSlots
  .map((slot) => {
    if (
      !checkForConflicts({
        time: slot.time,
        busy: busySlotsFromReservedSlots,
        ...availabilityCheckProps,
      })
    ) {
      return slot;
    }
    return undefined;
  })
Implementación optimizada: O(n log n) con ordenación y salida anticipada
function checkForConflicts({ sortedBusyTimes, time, eventLength }) {
  const slotStart = time.valueOf();
  const slotEnd = slotStart + eventLength * 60 * 1000;

  for (const busyTime of sortedBusyTimes) {
    if (busyTime.start >= slotEnd) {
      break;
    }
    if (busyTime.end <= slotStart) {
      continue;
    }
    return true;
  }
  return false;
}
Qué cambió:
Ordenamos los periodos ocupados por su hora de inicio, lo que nos permitió omitir los periodos que no se solapaban y salir antes cuando no podía haber conflictos. El resultado fue una caída drástica en el número de comparaciones innecesarias.
Impacto:
La complejidad pasó de O(huecos disponibles × periodos ocupados) a O(n log n), y en los casos habituales se omitieron por completo la mayoría de las comprobaciones.
Caso práctico 2: intersección de rangos de fechas usando la técnica de dos punteros
El problema original
La función intersect utilizaba antes bucles anidados para encontrar solapamientos entre la disponibilidad de varios usuarios.
Implementación original: mapeado anidado O(n²)
commonAvailability.forEach(commonRange => {
  userRanges.forEach(userRange => {
    const intersection = getIntersection(commonRange, userRange);
    if (intersection !== null) {
      intersectedRanges.push(intersection);
    }
  });
});
Implementación optimizada: O(n log n) con recorrido de dos punteros
const sortedRanges = ranges.map(userRanges =>
  userRanges
    .map(r => ({
      ...r,
      startValue: r.start.valueOf(),
      endValue: r.end.valueOf()
    }))
    .sort((a, b) => a.startValue - b.startValue)
);

let commonIndex = 0;
let userIndex = 0;

while (commonIndex < commonAvailability.length && userIndex < userRanges.length) {
  const commonRange = commonAvailability[commonIndex];
  const userRange = userRanges[userIndex];

  const intersectStartValue = Math.max(commonRange.startValue, userRange.startValue);
  const intersectEndValue = Math.min(commonRange.endValue, userRange.endValue);

  if (intersectStartValue < intersectEndValue) {
    intersectedRanges.push(createIntersection(commonRange, userRange));
  }

  if (commonRange.endValue <= userRange.endValue) {
    commonIndex++;
  } else {
    userIndex++;
  }
}
Qué cambió:
Al ordenar y usar dos punteros para recorrer los rangos, eliminamos la necesidad de iteración anidada. Esto redujo la complejidad de cuadrática a casi lineal en la mayoría de las entradas prácticas.
Caso práctico 3: árbol de intervalos para filtrar rangos redundantes
El problema original
La función filterRedundantDateRanges comparaba cada rango con todos los demás para ver si uno contenía al otro. En agendas grandes, esto se volvía dolorosamente lento.
Implementación original: comprobación de contención O(n²)
return dateRanges.filter((range, index) => {
  return !dateRanges.some((otherRange, otherIndex) => {
    if (index === otherIndex) return false;
    return isCompletelyContained(range, otherRange);
  });
});
Implementación optimizada: O(n log n) con un árbol de intervalos
export function filterRedundantDateRanges(dateRanges) {
  const sortedRanges = [...dateRanges].sort((a, b) => a.start.valueOf() - b.start.valueOf());
  const intervalNodes = createIntervalNodes(
    sortedRanges,
    (range) => range.start.valueOf(),
    (range) => range.end.valueOf()
  );
  const intervalTree = new IntervalTree(intervalNodes);
  const searchAlgorithm = new ContainmentSearchAlgorithm(intervalTree);

  return sortedRanges.filter((range, index) => {
    const containingIntervals = searchAlgorithm.findContainingIntervals(
      range.start.valueOf(),
      range.end.valueOf(),
      index
    );
    return containingIntervals.length === 0;
  });
}
Qué cambió:
En lugar de una comparación a fuerza bruta, usamos una estructura de árbol de intervalos para permitir consultas de contención rápidas O(log n). Es un enfoque clásico de geometría computacional que funciona de maravilla para aplicaciones de programación.
Resultados de rendimiento: antes y después
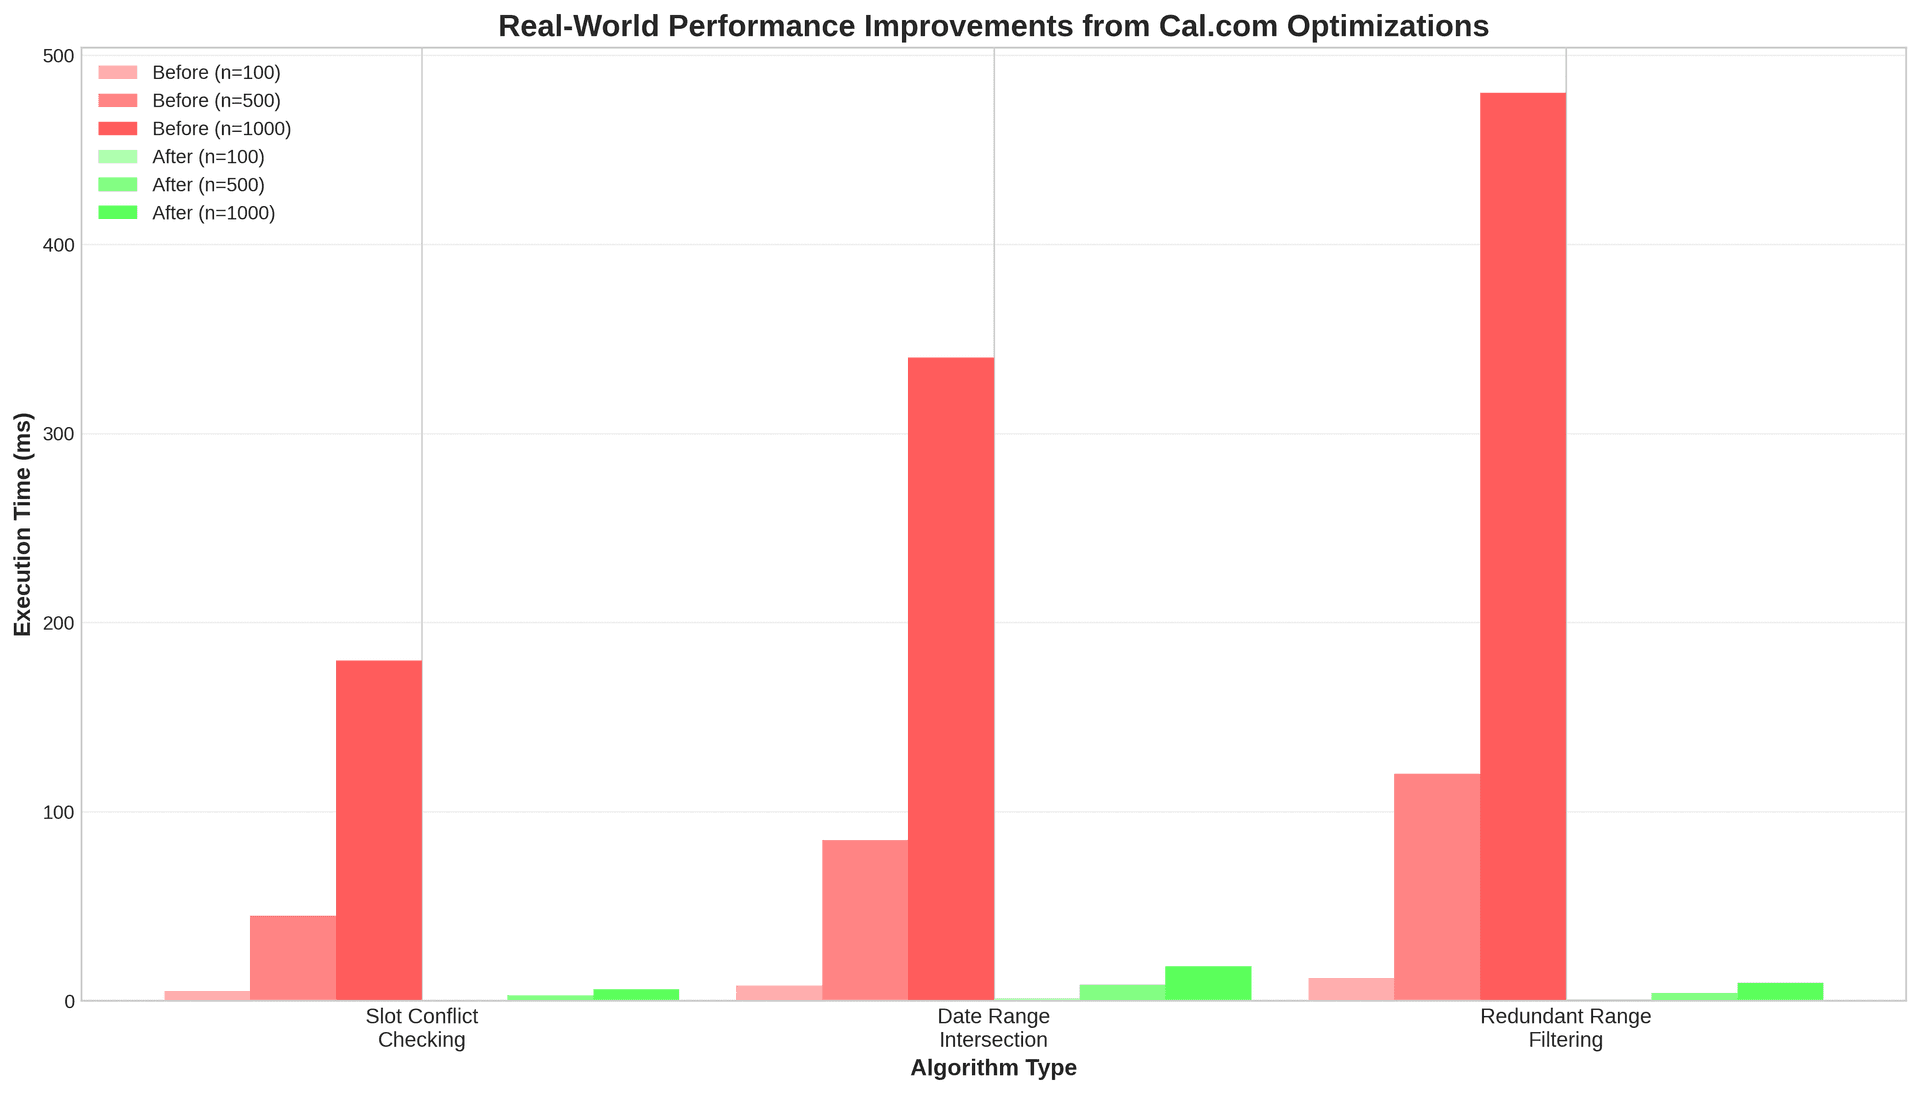
Nuestros benchmarks mostraron mejoras significativas:
-
Comprobación de conflictos de huecos: reducida de O(n²) a O(n log n), haciendo que 100 huecos y 50 periodos ocupados fueran unas diez veces más rápidos.
-
Intersección de rangos de fechas: pasó de O(n²) a O(n log n), permitiendo procesar cientos de rangos de fechas en milisegundos.
-
Filtrado de rangos redundantes: reducida de O(n²) a O(n log n), con hasta cincuenta veces más velocidad para miles de rangos de fechas.
-
Intersección general de rangos: en muchos patrones, vimos mejoras de veinticinco veces o más.

Técnicas sencillas para detectar algoritmos O(n²)
Reconoce patrones problemáticos
Fíjate en:
-
Iteraciones anidadas sobre arrays, especialmente
.map,.forEach,.filterdentro de otro. -
Métodos de arrays como
.some,.findo.filterdentro de bucles o callbacks de arrays. -
Filtros encadenados o mapeados anidados sobre listas grandes.
Prueba explícitamente la escalabilidad
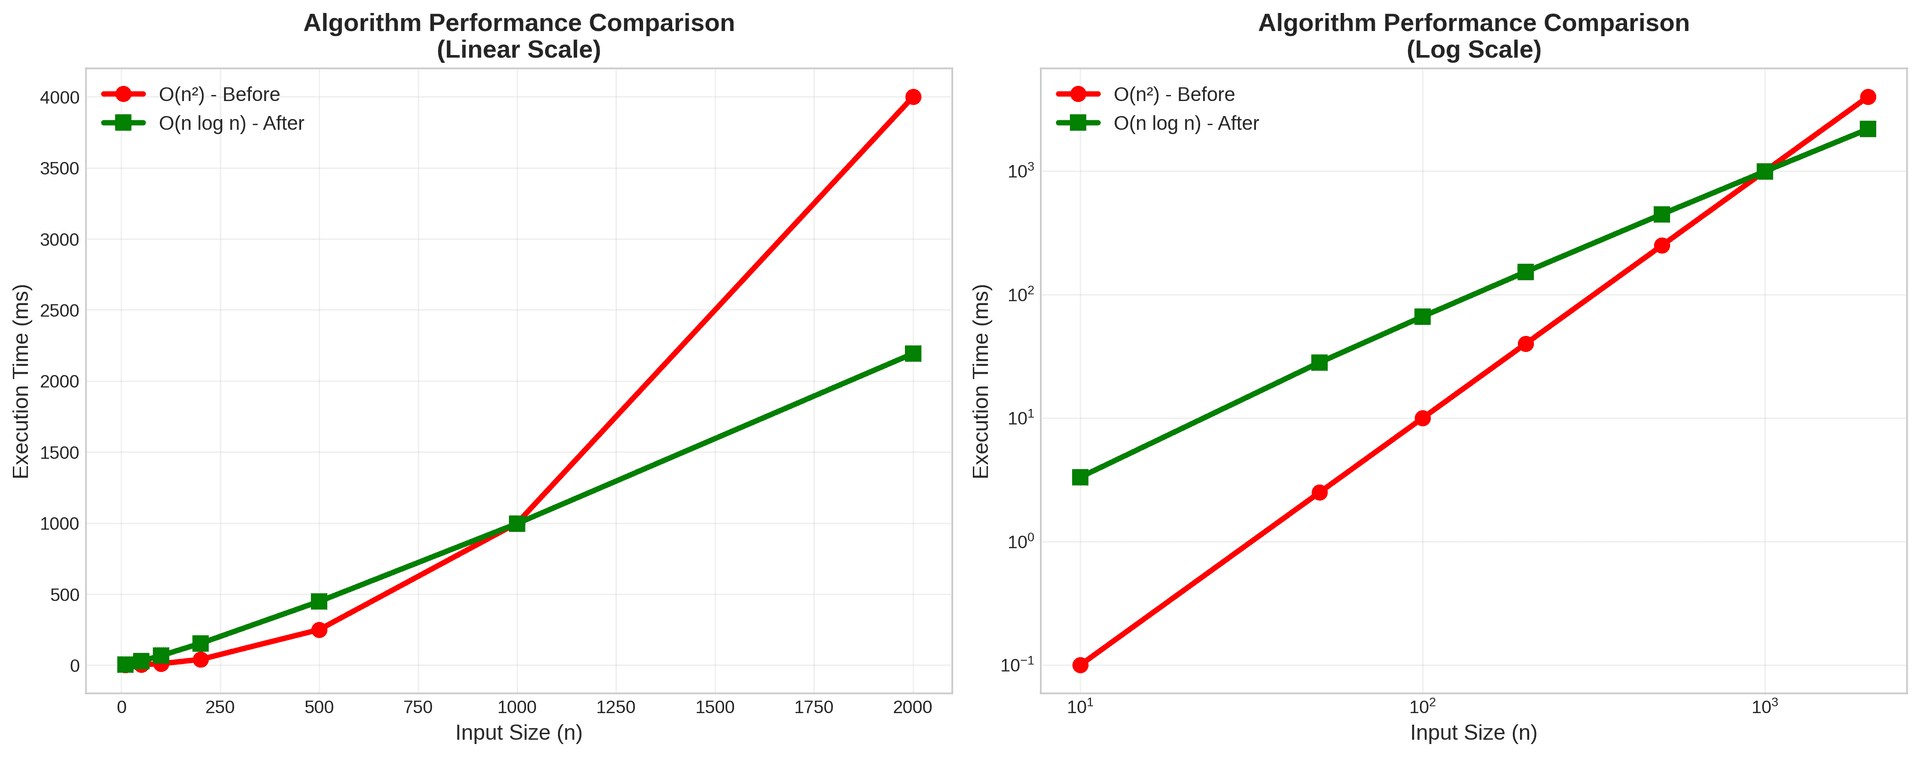
Escribe pruebas de rendimiento que ejecuten tu función con datos de tamaño creciente y registren los tiempos de ejecución. Si el tiempo crece cuadráticamente con el tamaño de los datos, tienes un problema O(n²).
Automatiza el análisis estático
Añade reglas de lint o análisis estático que:
-
Marquen funciones con bucles anidados o métodos de array anidados.
-
Identifiquen recursión sin memoización.
-
Detecten funciones con varias llamadas anidadas a
.some,.findo.filter.
Estrategias probadas para sustituir código O(n²)
-
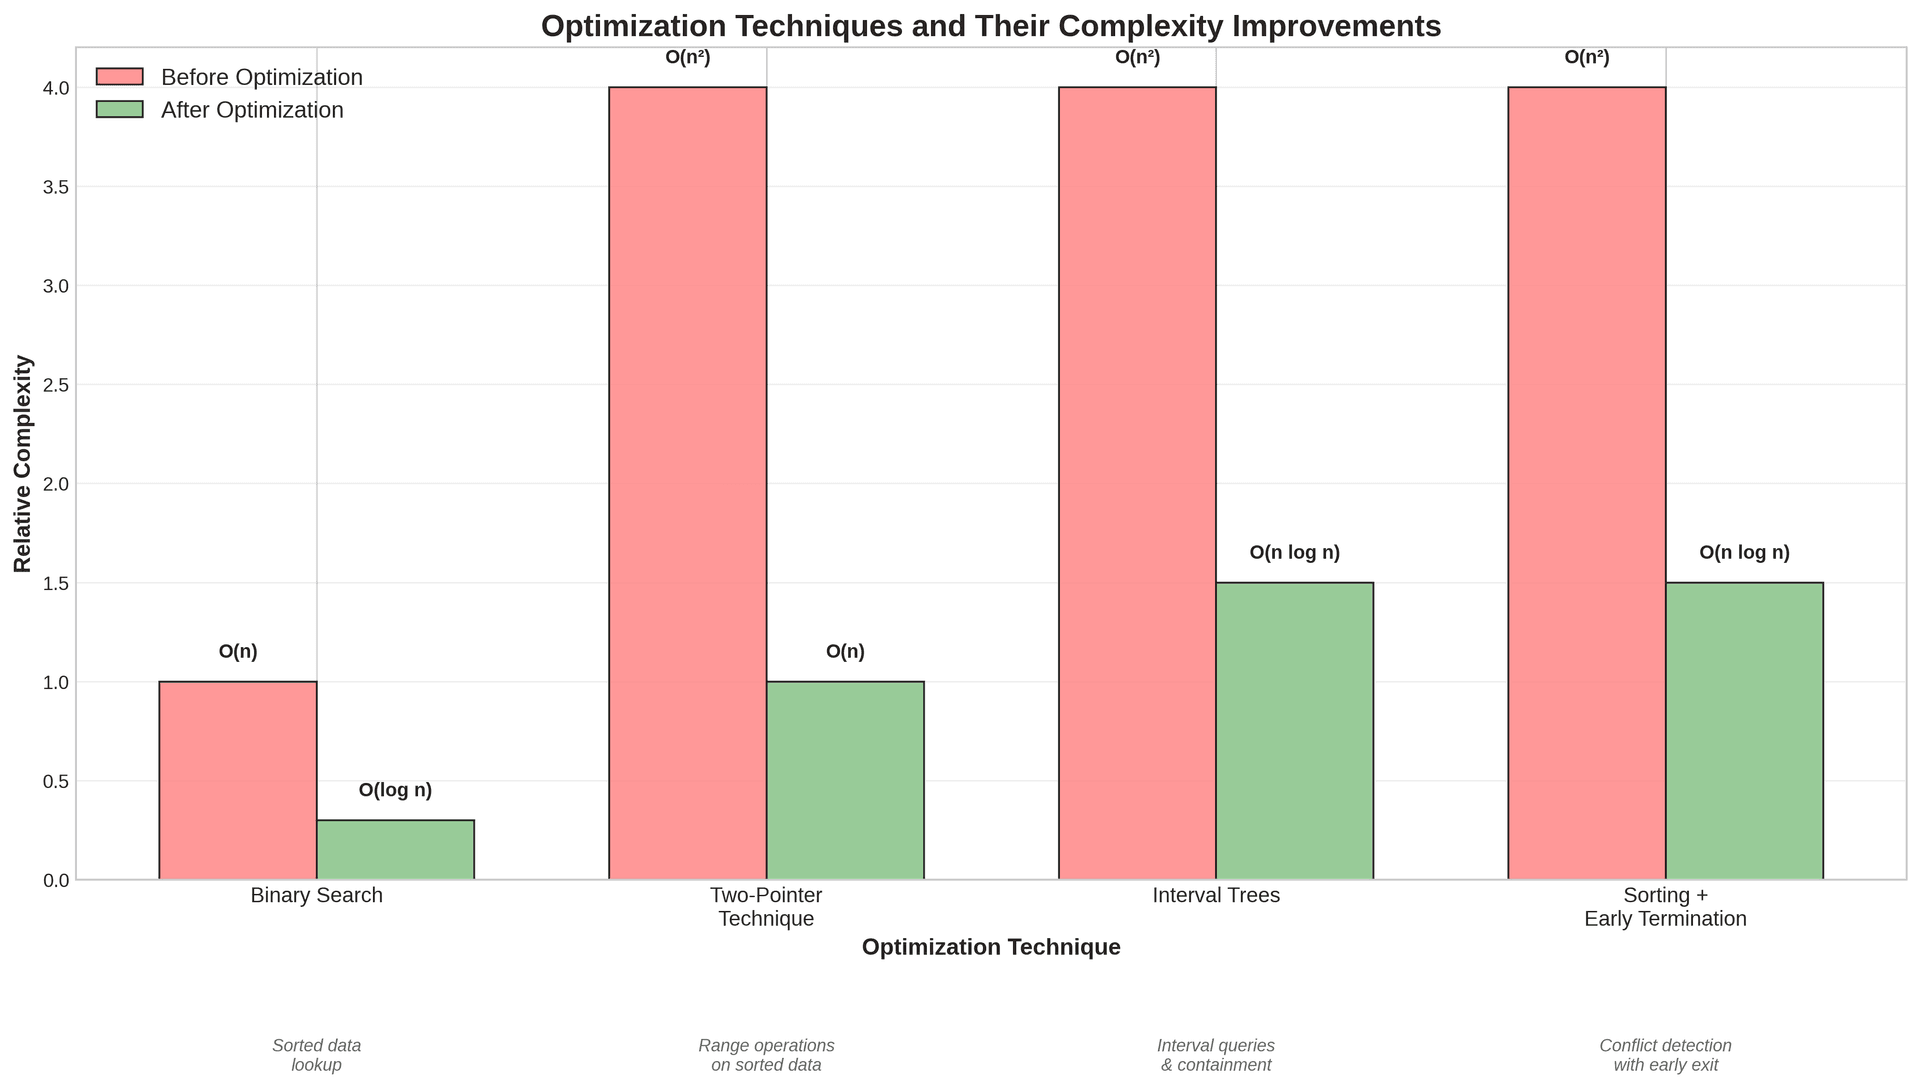
Usa búsqueda binaria para consultas en arrays ordenados.
-
Usa técnicas de dos punteros para fusionar o intersectar secuencias ordenadas.
-
Usa estructuras de datos basadas en árboles para consultas de intervalos o datos jerárquicos.
Automatizar las comprobaciones de rendimiento
Añade benchmarks de rendimiento a tu canalización de CI que ejecuten los algoritmos críticos con datos realistas. Compara los tiempos de ejecución en cada pull request y bloquea los merges que empeoren el rendimiento. Añade reglas de lint personalizadas para evitar que patrones O(n²) obvios lleguen nunca a producción. Implementa monitorización en tiempo de ejecución para las rutas críticas y detectar nuevas regresiones antes de que los usuarios las noten.
Conclusiones clave
-
Siempre es mejor prevenir que curar. Las comprobaciones automatizadas detectarán algoritmos O(n²) antes de que causen problemas.
-
Perfila siempre antes de optimizar. Usa pruebas para encontrar los cuellos de botella reales.
-
Elige las estructuras de datos adecuadas para tus necesidades. Los arrays ordenados, los enfoques de dos punteros y los árboles son invaluables.
-
Prueba con datos realistas y a gran escala. Las pruebas pequeñas pueden ocultar grandes problemas.
-
Monitoriza en producción. Las alertas automatizadas pueden detectar regresiones pronto.
Conclusión
Las optimizaciones que hicimos en Cal.com muestran que es posible lograr mejoras de rendimiento significativas aplicando técnicas algorítmicas probadas. Combina revisión de código, estructuras de datos inteligentes y monitorización automatizada para mantener tu aplicación rápida a medida que escala.
El rendimiento debería incorporarse en cada etapa del desarrollo, desde revisiones de código que marquen patrones sospechosos hasta canalizaciones de CI que ejecuten pruebas de escalabilidad y monitorización en tiempo de ejecución que detecte regresiones.
El algoritmo rápido de hoy puede convertirse fácilmente en el cuello de botella de mañana a medida que crezcan tus datos. Mantente alerta, prueba a escala y prepárate siempre para optimizar.